


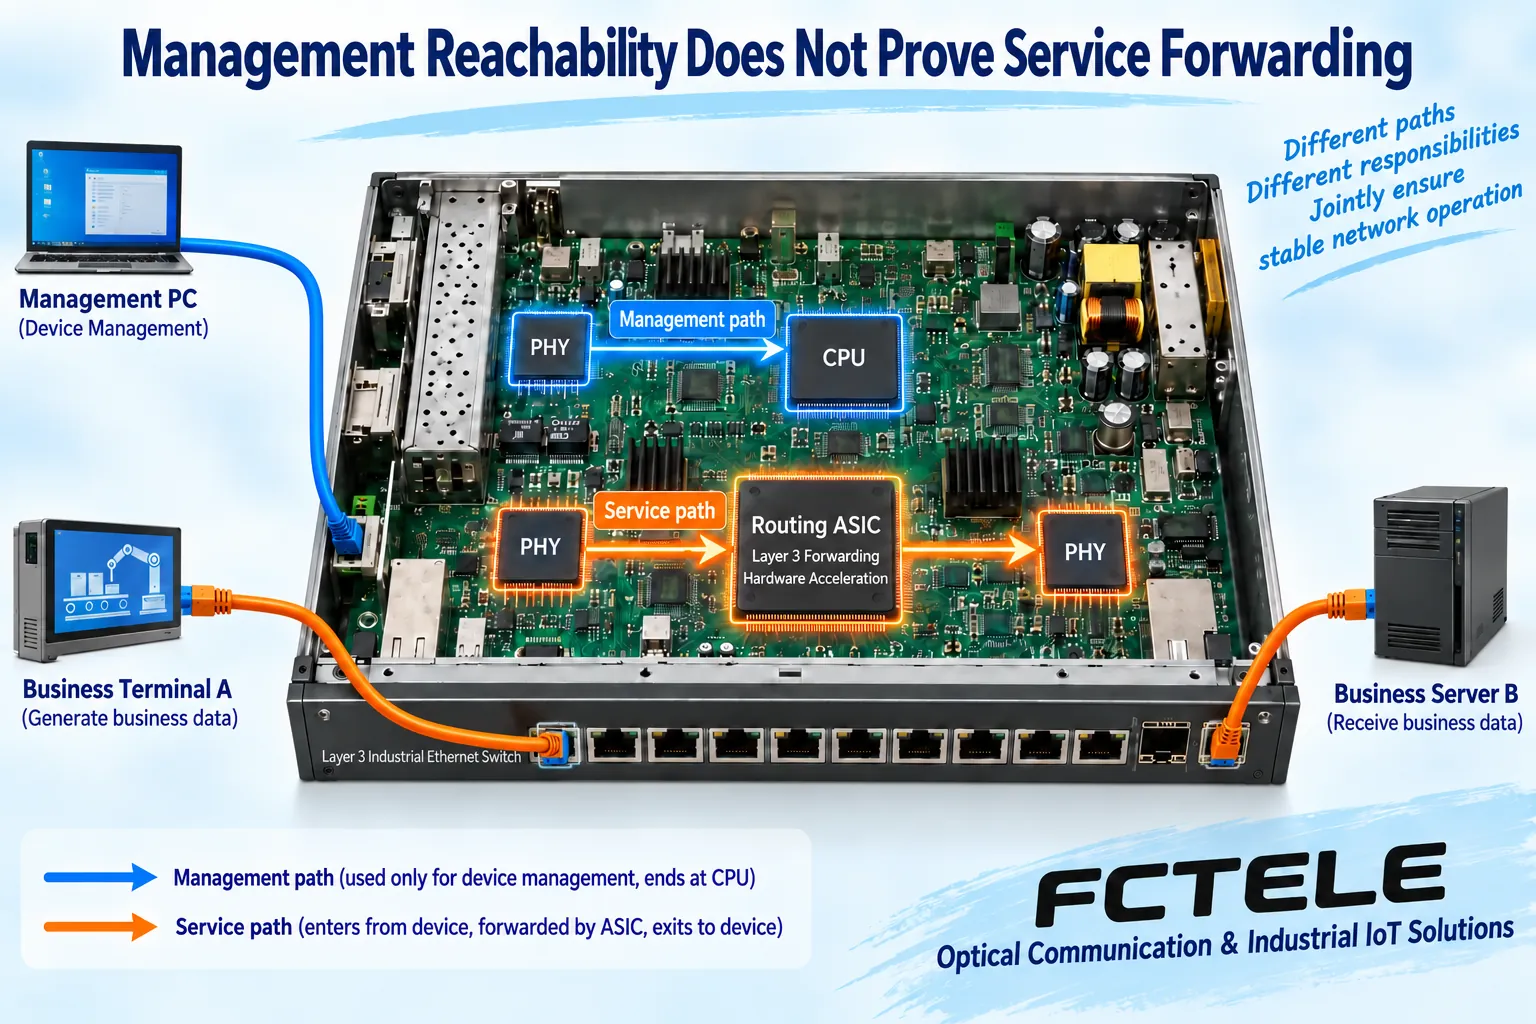
レイヤー3産業用イーサネットスイッチの管理では、「機器を管理できるか」と「サービスが正しく転送されているか」を区別する必要があります。Webページにログインできることは、その管理経路に到達できることを示すだけであり、すべてのVLAN、ルート、ネクストホップ、アクセスルールが正常である証明にはなりません。トラブルシューティングでは、サービスの実際の経路に沿って証拠を収集し、影響範囲が小さくロールバック可能な変更を行うべきです。接続できないたびに機器を再起動するべきではありません。
1. 管理アクセスとサービスデータは異なる経路を通る
管理用コンピューターがスイッチの管理アドレスにアクセスする場合、データの終端は機器自身の管理サービスです。一方、現場端末が別のサブネット上のサーバーにアクセスする場合、機器はデータを外部へ転送する必要があります。両者は異なるVLAN、ルール、インターフェースを通る場合があります。CPUが管理要求に応答できても、サービスの出口が正常とは限りません。また、管理アクセスが途絶えても、すべてのハードウェア転送が同時に停止したとは限りません。
まず、障害の範囲が特定のサービス、特定のサブネット、サイト全体のどれに該当するかを確認し、送信元、宛先、発生時刻、継続的かどうかを記録します。現象を単に「ネットワークがダウンしている」とまとめないでください。複数の担当者が同じ設定を同時に変更しないよう、管理アカウントの権限を分けます。納入されたモデルが対応する安全な管理方法を優先し、平文のリモートアクセスを信頼できないネットワークに公開しないでください。
2. サブネット間通信に失敗したら、まず到達性の状態を確認する
端末には正しいアドレス、マスク、ゲートウェイが必要であり、アクセスポートはトラフィックを正しいレイヤー2の範囲に収容する必要があります。対応するレイヤー3インターフェースが使用可能な状態で、機器には宛先に一致するルートも必要です。これらの基本条件を満たしていなければ、キューの優先度を変更したり、管理機能を追加で有効にしたりしても問題は解決しません。
ルーティングテーブルに宛先への経路が存在しても、ネクストホップの解決と出口を確認する必要があります。ネクストホップは、その時点でパケットを渡すべき隣接機器であり、最終的なサーバーとは限りません。IPv4では、多くの場合、ARPを通じて隣接機器のIPとMACの対応関係を確立します。解決に失敗した場合は、ローカルリンクや設定の確認が必要になることがあります。すぐに別のデフォルトルートを追加すると、症状がより複雑な経路問題に紛れてしまうため、避けるべきです。
入口、宛先への経路、ネクストホップ、アクセスルール、出口の状態を同じ時間帯で照合し、続いてサーバーからの復路を確認します。一般的なアクセス制御ルールでは一方向しか許可されていない場合があり、端末やサーバー自身の保護機能が要求を拒否する場合もあります。スイッチに原因があると疑うには裏付けとなる証拠が必要です。アプリケーションのタイムアウト1件だけで結論を出さないでください。
3. 累積値だけでなくカウンターの変化を見る
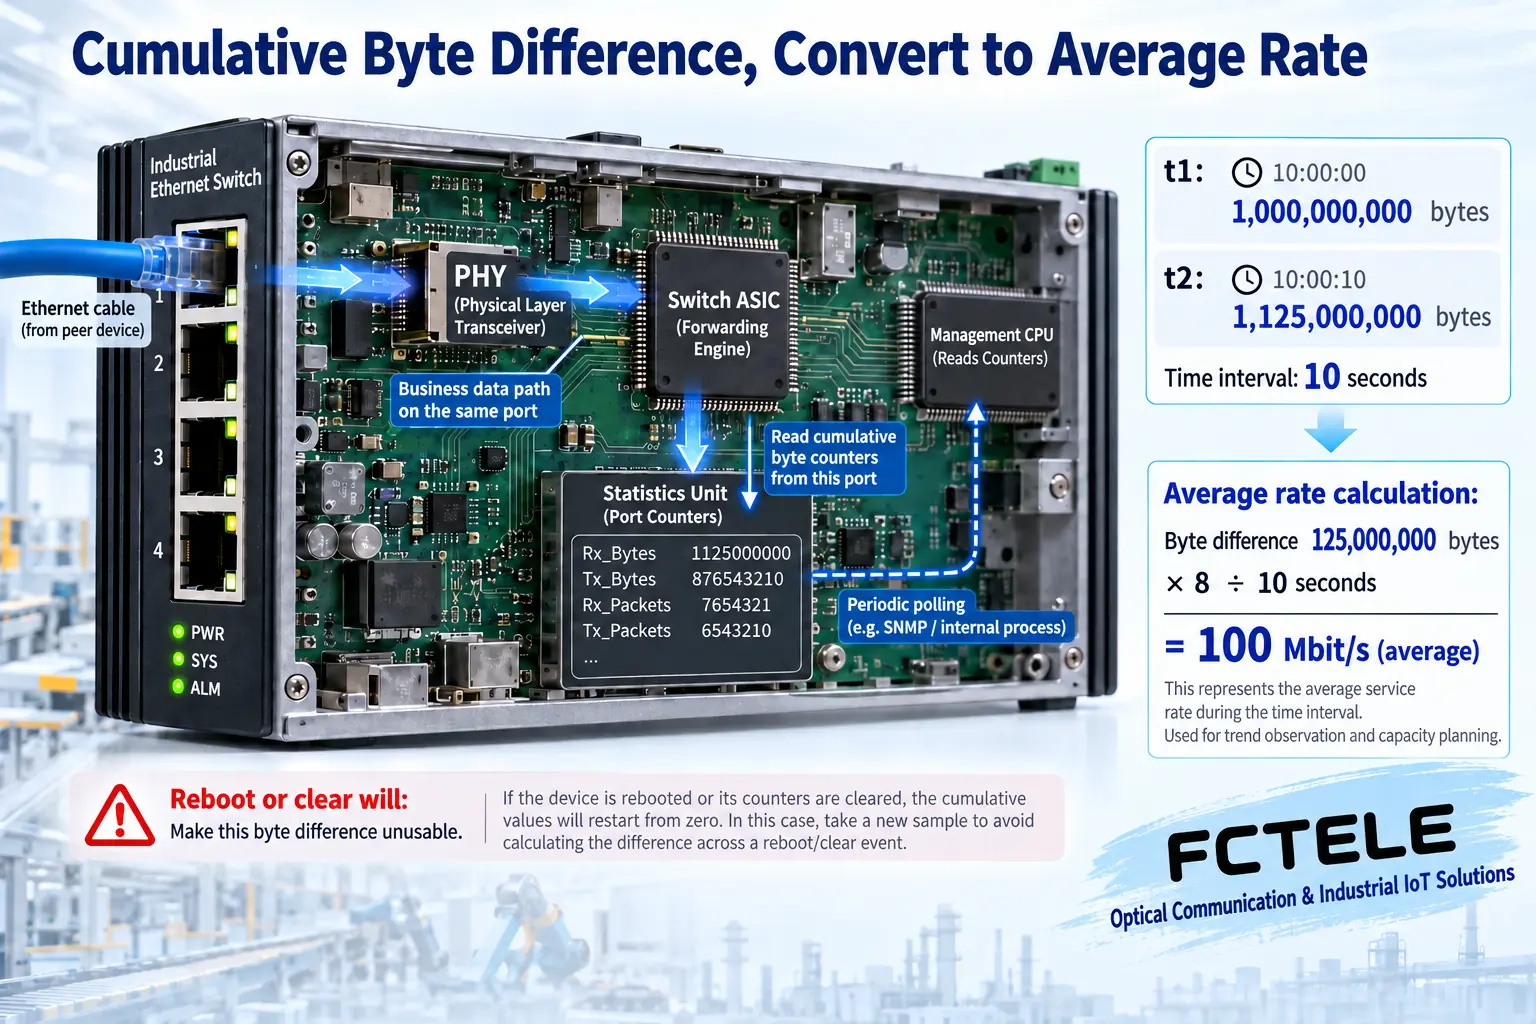
ポート統計には通常、累積バイト数、パケット数、各種エラー数や破棄数が保存されます。2つのサンプリング時点の間の変化を比較すると、障害中に何が起きたかをより適切に説明できます。大きな累積エラー数は過去のものかもしれません。一方、少数でも現在増え続けているエラーのほうが注意を要する場合もあります。まず、インターフェースインデックス、実際のポート、測定方向を一致させてください。異なる2つのポートの値を比較してはいけません。
説明用の例では、同じ出口のバイトカウントが10秒間に125,000,000バイト増加しています。この差分に8を掛け、10で割ると、平均レートは約100 Mbit/sになります。これは当該期間の平均であり、ピーク値ではなく、アプリケーションの実効スループットとも一致しません。機器の再起動、カウンターのクリア、カウンターの不連続が発生した場合、この差分をそのまま実際のレートとして扱うことはできません。高速ポートでは、カウンターのビット幅とツールの処理方法も確認する必要があります。
4. エラー、破棄、アプリケーションのタイムアウトを区別する
リンクの受信エラーと出口での破棄は、原因が同じではありません。前者は物理伝送、インターフェース、フレームに関係する場合があります。後者は輻輳、ルール、リソース、モデル固有の統計定義に関係する場合もあります。まず各カウンターの具体的な定義を確認し、そのうえで光モジュール情報、ポート速度、キュー、ログを関連付けて調べます。「破棄」が1件見つかっただけで、ケーブルの不良と即断することはできません。
ポートの平均使用率が低くても、バーストによるキューイングがない証明にはなりません。必要に応じて、許可された条件下でサンプリング頻度を上げるか、適切なパケットキャプチャを使用してください。ただし、ポートミラーリングでコピーして観測するトラフィックにも、容量と選択範囲の制限があります。ミラーポートでパケットを取得できなくても、ミラーリング自体の取りこぼしかもしれません。他の情報と照合せずに、元のサービスが何も送信していないと断定することはできません。
5. 飛暢科技の管理機能を保守の証拠として活用する方法
飛暢科技 マネージド産業用DINレール型10G 光4ポート・銅線8ポート レイヤー3スイッチ 詳細情報には、管理アクセス、ポート統計、ログ、光モジュール情報、対応するレイヤー3機能が記載されており、機器の状態とサービス経路の保守記録を作成するために利用できます。実際に読み取れる項目、更新周期、アラーム方式は、納入されたモデル、ファームウェア、マニュアルに基づいて確認してください。第三者のMIB定義だけでは、すべての項目に対応していることを証明できません。
異なる担当者が同じ障害を比較できるよう、設定のバックアップ、時刻同期の状態、ポート識別情報、ファームウェアのバージョンをまとめて保存します。ログの時刻とパケットキャプチャの時刻が一致しない場合は、異なる事象を1つの原因に結び付けないよう、まず証拠間の時刻の対応関係を補正します。ダッシュボードの数値を良く見せるためだけに、元のエラー記録をむやみに消去しないでください。
6. 最適化は検証された変更として行う
明確な仮説を立てた後、根拠のある設定項目を一度に1つずつ変更し、変更前後のサービス性能と機器の状態を記録します。ルート、VLAN、アクセスルールに関わる場合は、承認された作業時間帯とロールバック計画を用意してください。稼働中の制御ネットワークで、プロトコルをむやみに停止したり、アクセス権限を拡大したりしてはいけません。再起動によって症状が一時的に変わる場合はありますが、現場の重要な証拠が失われます。
受け入れ確認では管理ページだけでなく、元々障害が発生していたサービスが復旧したか、元々制限されていたサービスが引き続き制限されているか、復路と管理チャネルが維持されているかも確認する必要があります。どの区間の状態が異常だったのか、どう検証し、どう修正し、どう結果を再現したのかを説明できることは、「ネットワークをインテリジェントに最適化した」と漠然と述べるよりも信頼できます。
参考注記:インターフェースカウンターと不連続の処理については、次を参照してください: RFC 2863 。図は一般的な原理図であり、例は特定モデルの測定結果ではありません。具体的なカウンターの定義は、機器のドキュメントで確認してください。
中国語の技術記事から翻訳。原文の初回公開日:2024-03-06。原文の最終改訂日時:2026-10-13T11:20:43+08:00。 中国語の原文を読む
