


ESCAPE DEI BYTE SERIALI
Come può un delimitatore essere anche un dato?
Un ricevitore seriale vede caratteri, mentre l’applicazione deve identificare i messaggi. SLIP codifica mediante escape i byte C0 e DB del payload usando sequenze di due byte, in modo che un END senza escape possa delimitare un pacchetto. Il ricevitore inverte la mappatura mantenendo il proprio stato tra le letture. Questi valori specifici appartengono a SLIP e non forniscono automaticamente controlli degli errori o sicurezza.
Carattere e pacchetto
Il solo confine di un carattere non identifica un messaggio applicativo.
Applicare l’escape ai dati speciali
SLIP rappresenta i byte speciali del payload con sequenze di due byte.
Mantenere lo stato
Un parser deve conservare il proprio stato di escape anche quando una lettura termina dopo DB.
Mappare gli endpoint e l'ambito di protezione.
Confermare il protocollo e le impostazioni effettivi.
Eseguire test autorizzati con dati innocui.
Lista di controllo per selezione e verifica — espandi
Confermare il protocollo e il livello di acquisizione; provare byte ordinari e speciali; verificare letture suddivise, marcatori duplicati e gestione degli errori in un ambiente autorizzato.
Una linea seriale fornisce un flusso di byte. Come fa il programma ricevente a sapere dove termina un messaggio? Un approccio consiste nel riservare un marcatore. Tuttavia, una misura o un file può contenere lo stesso valore di byte e inviarlo senza modifiche potrebbe farlo interpretare come una terminazione. L’escape dei byte risolve questa ambiguità. Per comprenderlo, occorre distinguere la ricezione dei caratteri, i confini dei pacchetti e il significato applicativo, anziché considerare soltanto il baud rate.
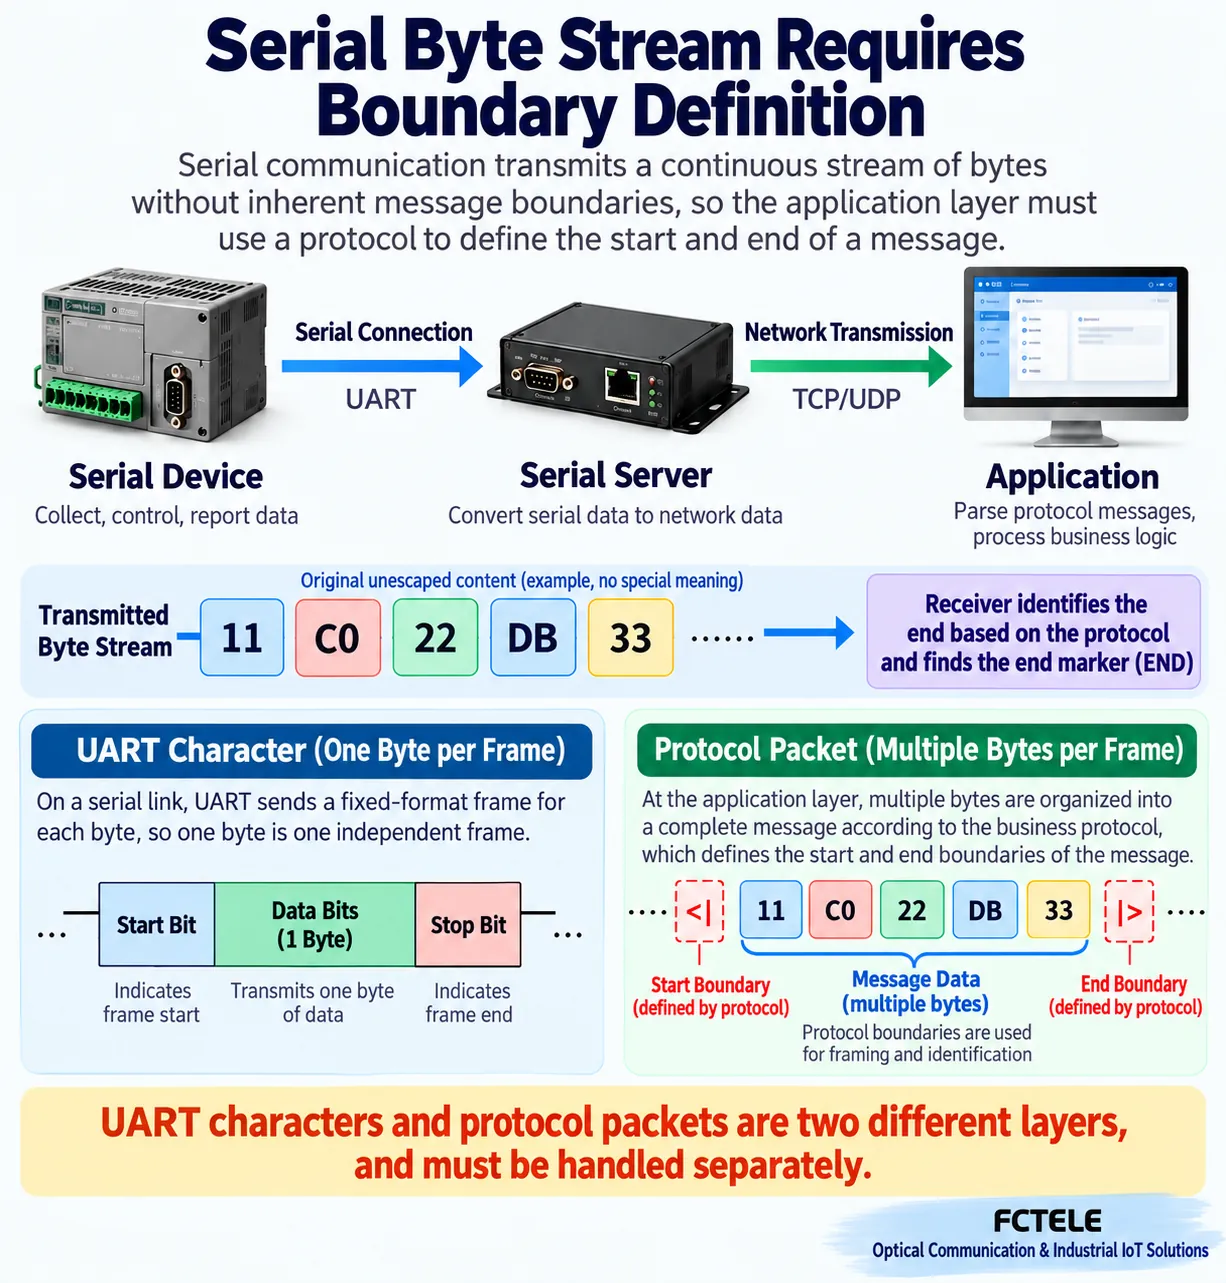
Caratteri corretti non formano automaticamente un pacchetto
Una comune interfaccia seriale asincrona utilizza un bit di start, bit di dati e bit di stop per identificare un carattere. Una volta giunti a un programma, i caratteri formano una sequenza di byte. Il ricevitore non sa automaticamente dove inizia e termina una lettura di temperatura. I confini dei caratteri e quelli dei messaggi completi sono problemi distinti.
Un protocollo applicativo può usare una lunghezza fissa, un campo di lunghezza, criteri temporali o marcatori speciali per delimitare i messaggi. Ogni metodo presenta condizioni e compromessi. Questo articolo usa SLIP, un semplice esempio di delimitazione dei pacchetti seriali, per spiegare marcatori ed escape. Non suggerisce che ogni protocollo seriale utilizzi SLIP né che un protocollo esistente debba essere modificato con leggerezza.
Il server di dispositivi seriali Feichang FCT-1100-F1S1, a porta singola e tre in uno, offre un contesto reale di collegamento dalla seriale alla rete. I byte inoltrati attraverso un’interfaccia o una rete non acquisiscono automaticamente un nuovo significato operativo. Questo articolo non deduce quale protocollo di delimitazione utilizzi internamente il prodotto; consultarne la documentazione e la configurazione per verificarne le effettive funzionalità.
Perché un marcatore può avere due ruoli
Supponiamo che entrambi gli estremi concordino che un determinato byte indichi la fine. Quando lo riceve, un parser consegna i dati precedenti accumulati nel buffer. L’idea ricorda la punteggiatura che segna la fine di una frase. Il contenuto binario, tuttavia, può contenere qualsiasi valore di byte; nessun valore scelto è automaticamente assente dal payload.
Un record di misurazione potrebbe contenere lo stesso valore del marcatore di fine. Il parser deve trattare tale occorrenza come un dato o come un confine? Il solo valore non consente di risolvere entrambe le interpretazioni. Mittente e ricevitore devono condividere una regola che modifichi la rappresentazione dei valori speciali sulla linea.
Vietare semplicemente un valore limita ciò che i dati originali possono esprimere e può modificare le misure senza segnalarlo. Nemmeno sostituire il rame con la fibra elimina l’ambiguità: la conversione ottica cambia il mezzo trasmissivo, non l’interpretazione del protocollo applicativo. La qualità del collegamento e le regole di codifica devono essere verificate separatamente.
L’escape cambia la rappresentazione, non i dati
L’escape può essere inteso come un segnale che indica di interpretare il byte successivo secondo una regola concordata. Il mittente esamina il payload e sostituisce i valori di byte protetti con sequenze speciali. Il ricevitore inverte la mappatura e dovrebbe ottenere lo stesso contenuto originale.
Nell’esempio SLIP descritto nella RFC 1055, il valore esadecimale C0 è END e DB è ESC. Un C0 all’interno del payload diventa DB DC; un DB all’interno del payload diventa DB DD. Un C0 senza escape costituisce il confine finale effettivo. Questi valori specifici appartengono a questo esempio, non a ogni protocollo seriale.
Perché applicare l’escape anche a DB? Perché introduce un’interpretazione speciale del byte successivo. Se un DB originale fosse inviato senza distinguerlo, il valore ordinario successivo potrebbe essere scambiato per un suffisso di escape. Proteggere sia il delimitatore sia l’introduttore di escape evita di creare una nuova ambiguità.
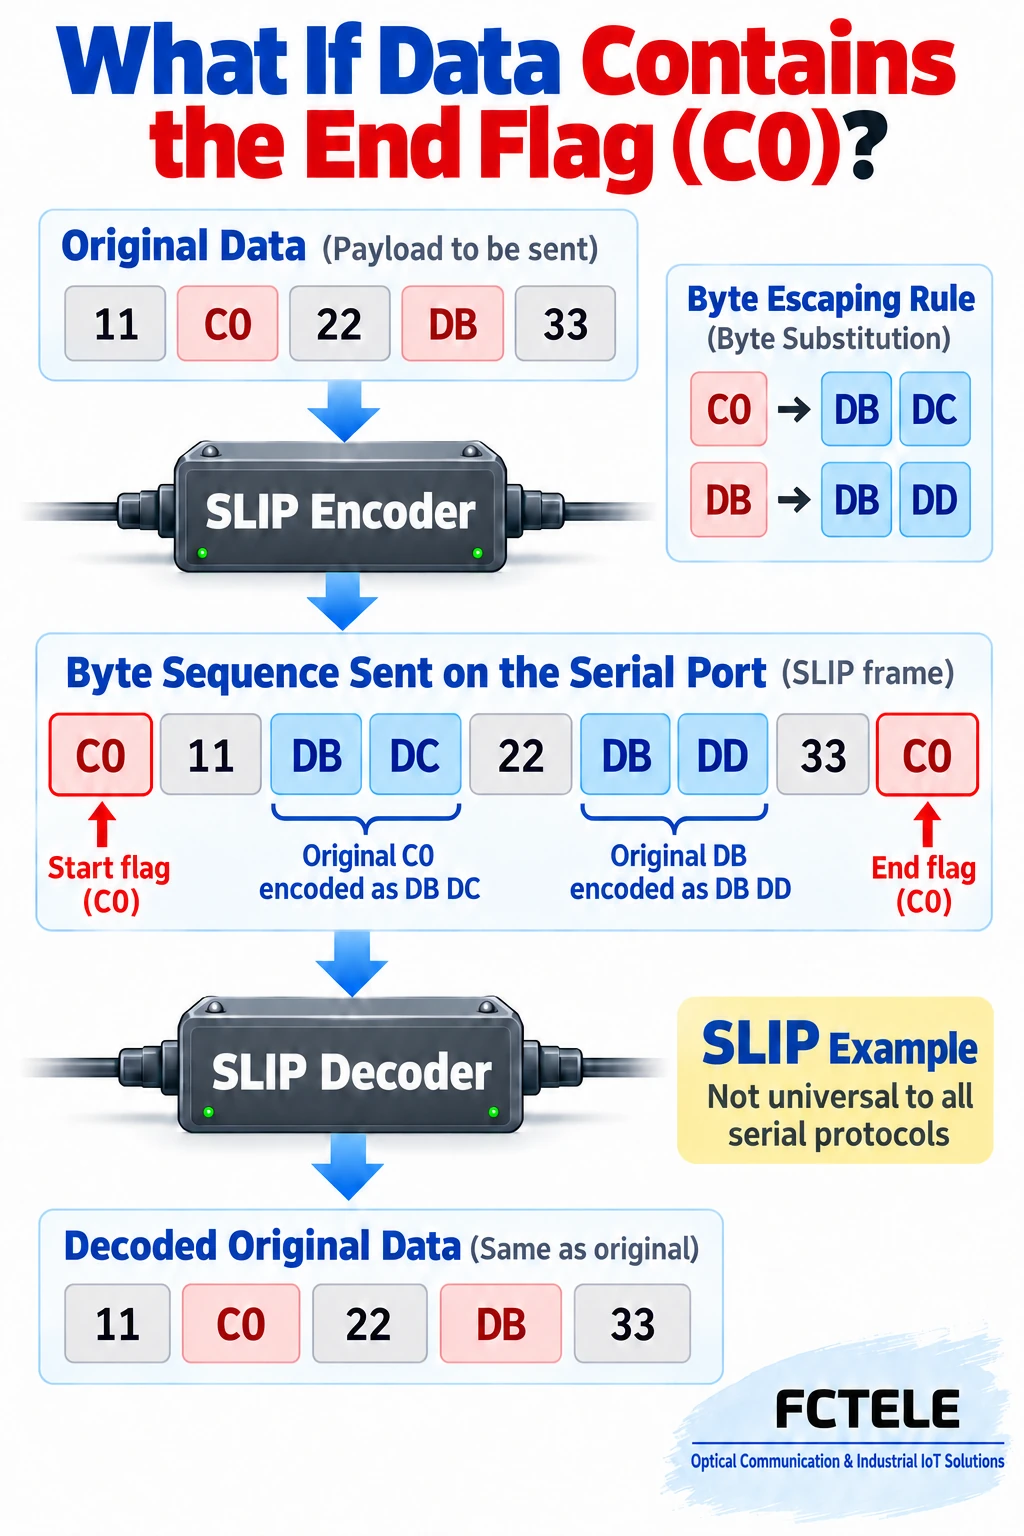
Seguire un breve esempio dal mittente al ricevitore
Consideriamo il payload originale 11 C0 22 DB 33. I due valori speciali non possono essere inseriti direttamente nel flusso delimitato come contenuto ordinario. La codifica produce 11 DB DC 22 DB DD 33; i veri marcatori END delimitano il risultato, così il ricevitore può distinguere le funzioni di controllo dai dati ripristinati.
Questa illustrazione colloca C0 sia prima sia dopo il pacchetto. La RFC 1055 descrive l’invio di un END all’inizio come metodo per eliminare il rumore accumulato; un risultato di lunghezza zero prodotto da marcatori consecutivi non dovrebbe essere consegnato come un normale pacchetto IP. Altri protocolli non usano necessariamente marcatori identici alle due estremità.
Dopo la decodifica, C0 e DB del payload tornano a essere dati ordinari. I delimitatori stessi non fanno parte del contenuto consegnato. La codifica può aumentare il numero di byte sulla linea. I contatori dei server seriali, le acquisizioni e le lunghezze rilevate dall’applicazione possono differire se misurati a livelli diversi, senza che ciò dimostri una perdita di dati.
Un ricevitore deve ricordare il proprio stato corrente
Il parser non può sempre interpretare ogni byte isolatamente. Deve almeno distinguere la lettura normale dall’attesa di un suffisso dopo un introduttore di escape. Nello stato normale, un END indica il confine del pacchetto; un DB porta allo stato di attesa del suffisso, anziché emettere immediatamente DB come dato originale.
Nello stato di attesa, il ricevitore applica la mappatura concordata e torna allo stato normale. La relazione tra i due byte è mantenuta dallo stato del parser; non è necessario che i byte arrivino nella stessa lettura software. Se una lettura termina con DB e la successiva inizia con DC, il ricevitore deve conservare lo stato e completare la conversione.
Un’implementazione reale richiede anche regole per suffissi non validi, limiti del buffer, pacchetti vuoti e interruzioni. Questo articolo non impone una strategia universale di gestione degli errori. Se il software azzera lo stato del parser a ogni lettura di rete, oppure presume che ogni lettura sia un messaggio, la delimitazione può fallire anche se il trasporto ha consegnato tutti i byte.
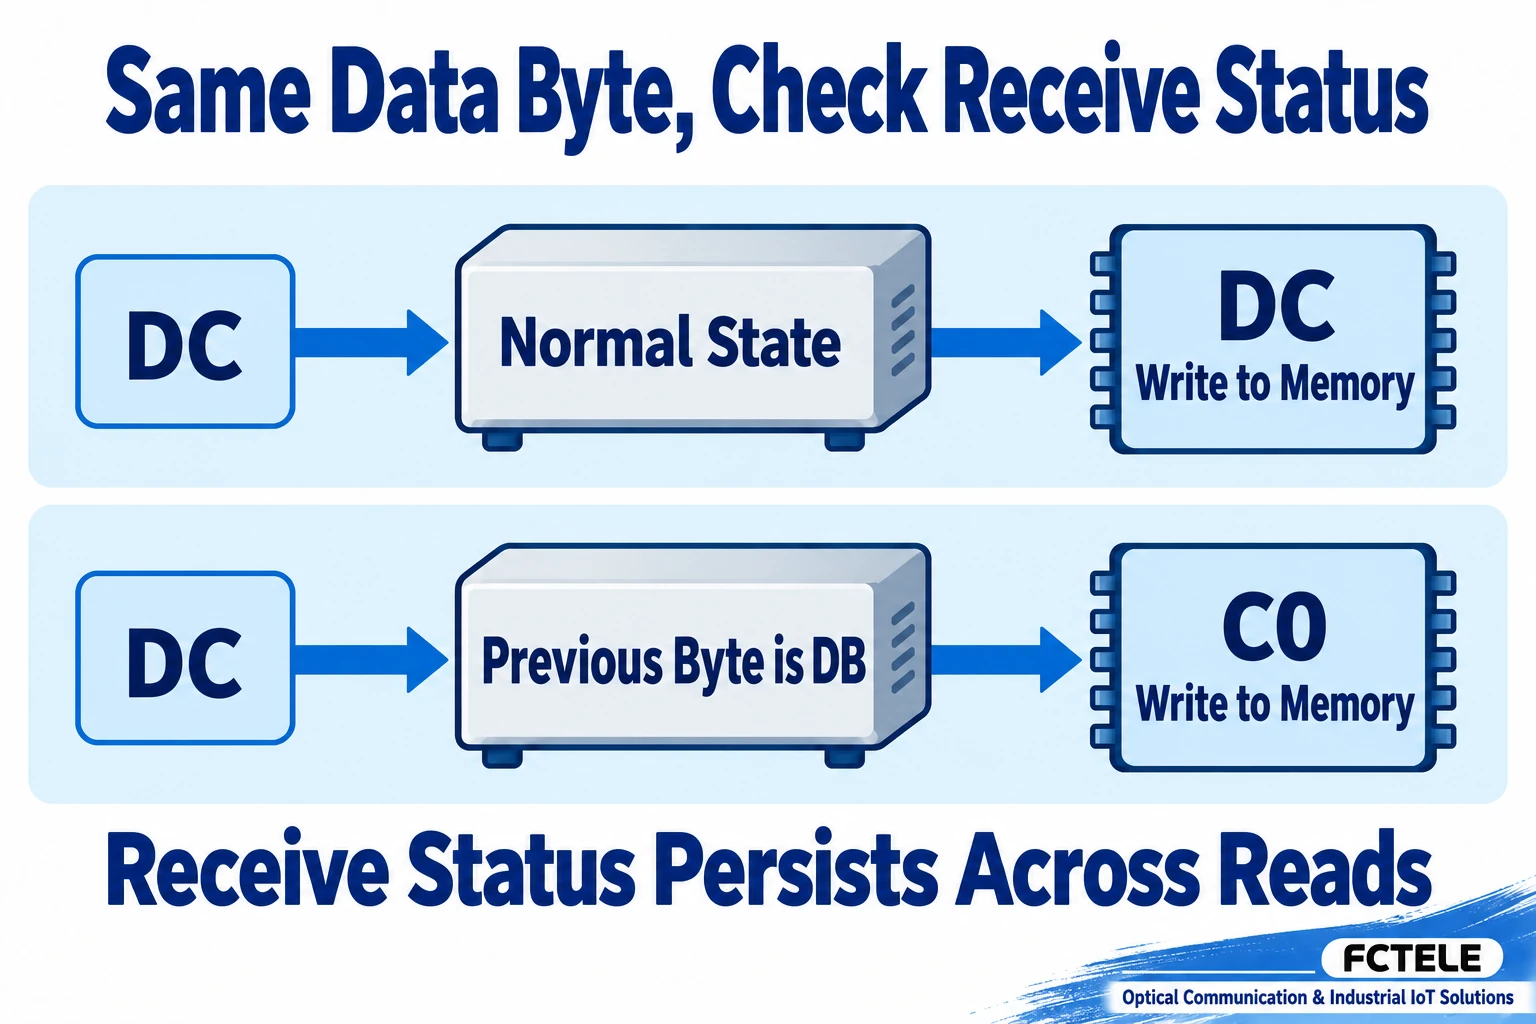
Un confine non è un controllo degli errori né una garanzia di sicurezza
L’escape risolve l’ambiguità di rappresentazione. Non aggiunge automaticamente rilevamento degli errori, ritrasmissione, autenticazione o crittografia. Suddividere un flusso in pacchetti non dimostra che ogni pacchetto sia corretto o che il mittente sia affidabile. SLIP offre di per sé servizi limitati e non deve essere considerato un protocollo generale di sicurezza per il controllo industriale.
Protocolli diversi possono inoltre applicare controlli ed escape in fasi differenti. La delimitazione di PPP simile a HDLC ha regole proprie per flag, trasparenza e controllo delle trame; questi dettagli non sono identici a quelli di SLIP. Mescolare valori dei marcatori, suffissi di escape o fasi di controllo può far sì che entrambi i lati ricevano byte senza che nessuno dei due accetti un pacchetto.
Individuare dove si collocano i dati applicativi originali, la codifica, il trasporto fisico o di rete, la decodifica e la validazione applicativa. Quando si indagano errori, identificare il livello di osservazione prima di confrontare il contenuto atteso. Un confronto diretto byte per byte tra traffico codificato e campi applicativi decodificati può far apparire un guasto inesistente.
Verificare le regole concordate con piccoli campioni ripetibili
Iniziare dalla documentazione del dispositivo e del protocollo. Annotare versioni, impostazioni dell’interfaccia, pacchettizzazione e punti di acquisizione. Provare dati ordinari, dati contenenti il valore di fine, dati contenenti il valore di escape e valori speciali consecutivi. Verificare sia le forme codificate sia quelle decodificate. Questi sono metodi illustrativi, non un’affermazione che siano state eseguite misurazioni su un particolare prodotto.
Provare quindi letture suddivise, letture aggregate e connessioni interrotte, laddove l’implementazione debba gestirle. Usare dati innocui in un ambiente autorizzato, senza utilizzare i byte di esempio come comandi in un sistema di produzione attivo. Se gli estremi usano protocolli diversi, stabilire chi esegue la conversione prima di modificare ripetutamente i baud rate.
Ricordare i livelli: UART identifica i caratteri, una regola di delimitazione identifica i messaggi e l’escape impedisce che i valori speciali del payload siano scambiati per marcatori di controllo. Distinguerli spiega perché una porta può ricevere byte mentre un’applicazione non riesce comunque a ricostruire un messaggio completo.
Riferimenti principali
RFC 1055: SLIP, giugno 1988, non è uno standard Internet; RFC 1662: PPP con delimitazione simile a HDLC, luglio 1994. Contesto del prodotto: Server per dispositivi seriali FCT-1100-F1S1; ciò non implica che utilizzi SLIP.
Tradotto dall'articolo tecnico in cinese: Leggi l'articolo originale in cinese.
Domande pratiche frequenti
La ricezione di caratteri seriali identifica automaticamente un pacchetto?
No. La ricezione dei caratteri UART e la delimitazione applicativa sono funzioni distinte; entrambi gli estremi devono usare le stesse regole di delimitazione.
Come applica SLIP l’escape ai byte C0 e DB del payload?
C0 nel payload diventa DB DC e DB nel payload diventa DB DD; END senza escape indica un confine. Altri protocolli possono usare regole diverse.
L’escape dei byte sostituisce i controlli di integrità o la crittografia?
No. Elimina l’ambiguità tra marcatori di controllo e valori del payload; non fornisce automaticamente rilevamento degli errori, ritrasmissione, autenticazione o crittografia.
Ambito e approfondimenti
Esempio generico di delimitazione SLIP, non un’affermazione relativa a un prodotto specifico o a dati misurati.
Chiusura parziale TCP e risposte seriali · Carichi unitari RS485 e capacità di pilotaggio disponibile
