


FCTEL Articolo tecnico originale · Team tecnico FCTEL
Prima pubblicazione: 2026-10-05 · Ultima modifica: 2026-10-05
Il grafico di utilizzo di una porta non mostra picchi, eppure un'immagine di visione artificiale perde occasionalmente dei frame e una risposta del PLC rallenta improvvisamente. Una possibile causa è un microburst: più dispositivi trasmettono verso la stessa uscita in un breve intervallo. Lo switch non può trasmettere tutto immediatamente e deve memorizzare temporaneamente i frame; uno spazio di buffer insufficiente può causare scarti. Questo articolo segue le fasi di ricezione, accodamento, schedulazione e trasmissione, distinguendo tra meccanismi generali, calcoli illustrativi e funzionalità esplicitamente documentate per i prodotti FCTEL.
Aprire l'immagine originale per vedere i dettagli. Scorrere orizzontalmente per leggere le etichette del diagramma a grandezza naturale.
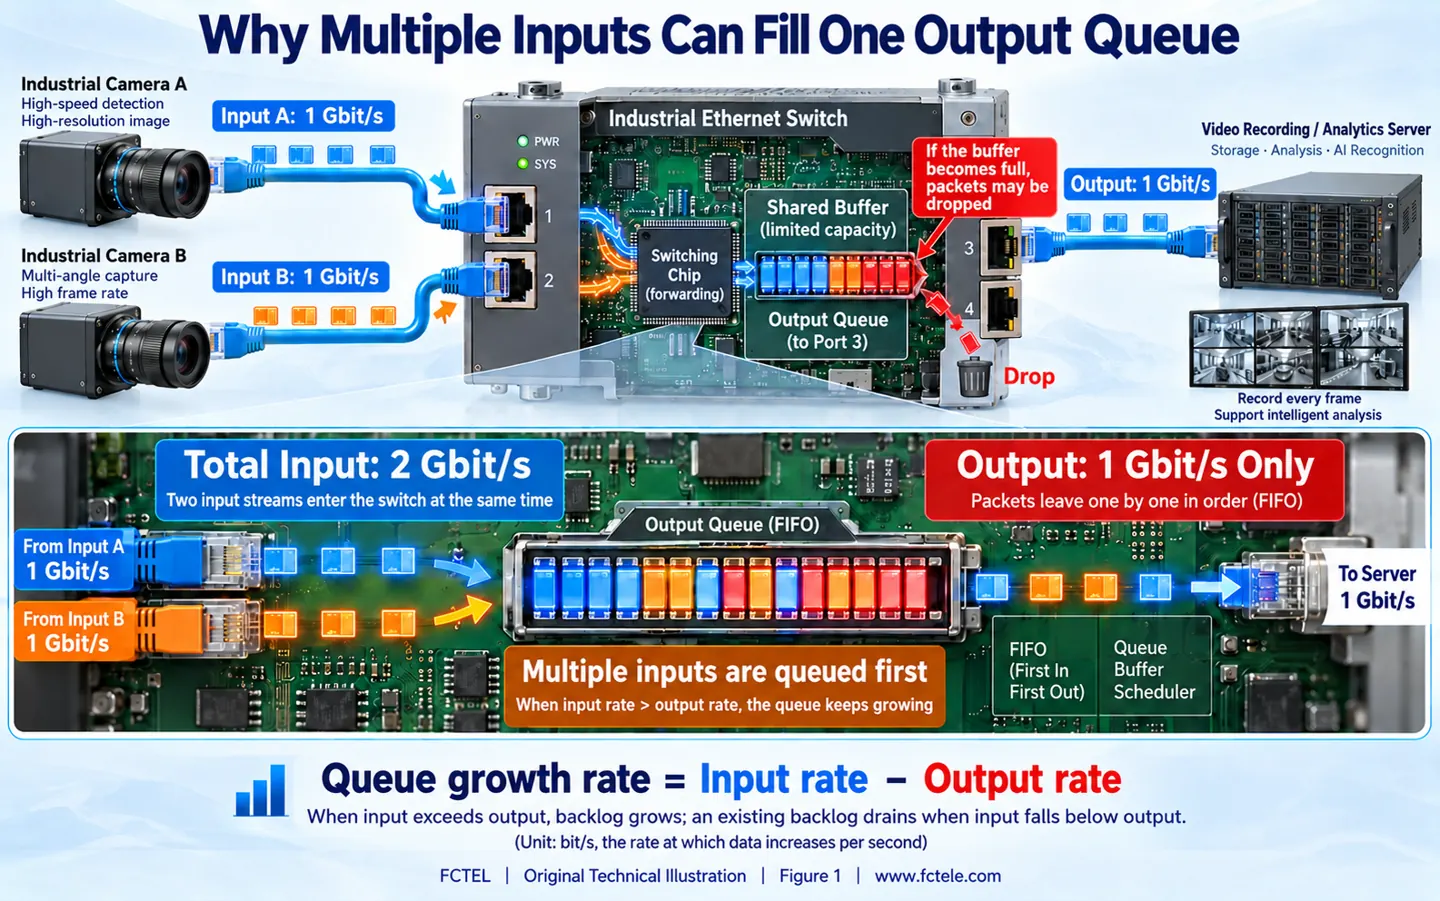
1. Perché più ingressi Gigabit possono contendersi una sola uscita
Dopo aver ricevuto un frame Ethernet, uno switch ne determina l'uscita utilizzando la tabella di inoltro e le politiche applicabili. Più ingressi possono ricevere simultaneamente, ma una normale uscita fisica continua a serializzare i frame alla propria velocità di linea in una determinata direzione di trasmissione. Quando due telecamere inviano immagini allo stesso server di analisi, entrambe le connessioni possono negoziare il funzionamento Gigabit pur contendendosi l'unica porta Gigabit dello switch collegata al server. Aggiungere ingressi non aumenta la capacità di tale uscita.
Un buffer è uno spazio di memorizzazione per i dati dei frame; una coda comprende i dati in attesa e la relazione di gestione utilizzata per servirli. Sono concetti correlati, ma non intercambiabili. Un chip di commutazione può utilizzare memoria condivisa, allocazioni per porta e più code di traffico. Le sue regole di allocazione determinano quanto spazio un'uscita può utilizzare in quel momento. La specifica del buffer totale di un prodotto non significa che ogni porta disponga esclusivamente di tale quantità, né specifica direttamente per quanto tempo una determinata applicazione possa restare in attesa.
La situazione esaminata qui è quella di un carico in uscita che supera temporaneamente la capacità di servizio. È diversa da un loop che replica continuamente i frame e da un'interferenza che corrompe un frame su un collegamento in rame. Individuare il punto di congestione e la direzione del traffico prima di attribuire ogni evento di perdita a un cavo o a uno switch guasto.
Aprire l'immagine originale per vedere i dettagli. Scorrere orizzontalmente per leggere le etichette del diagramma a grandezza naturale.
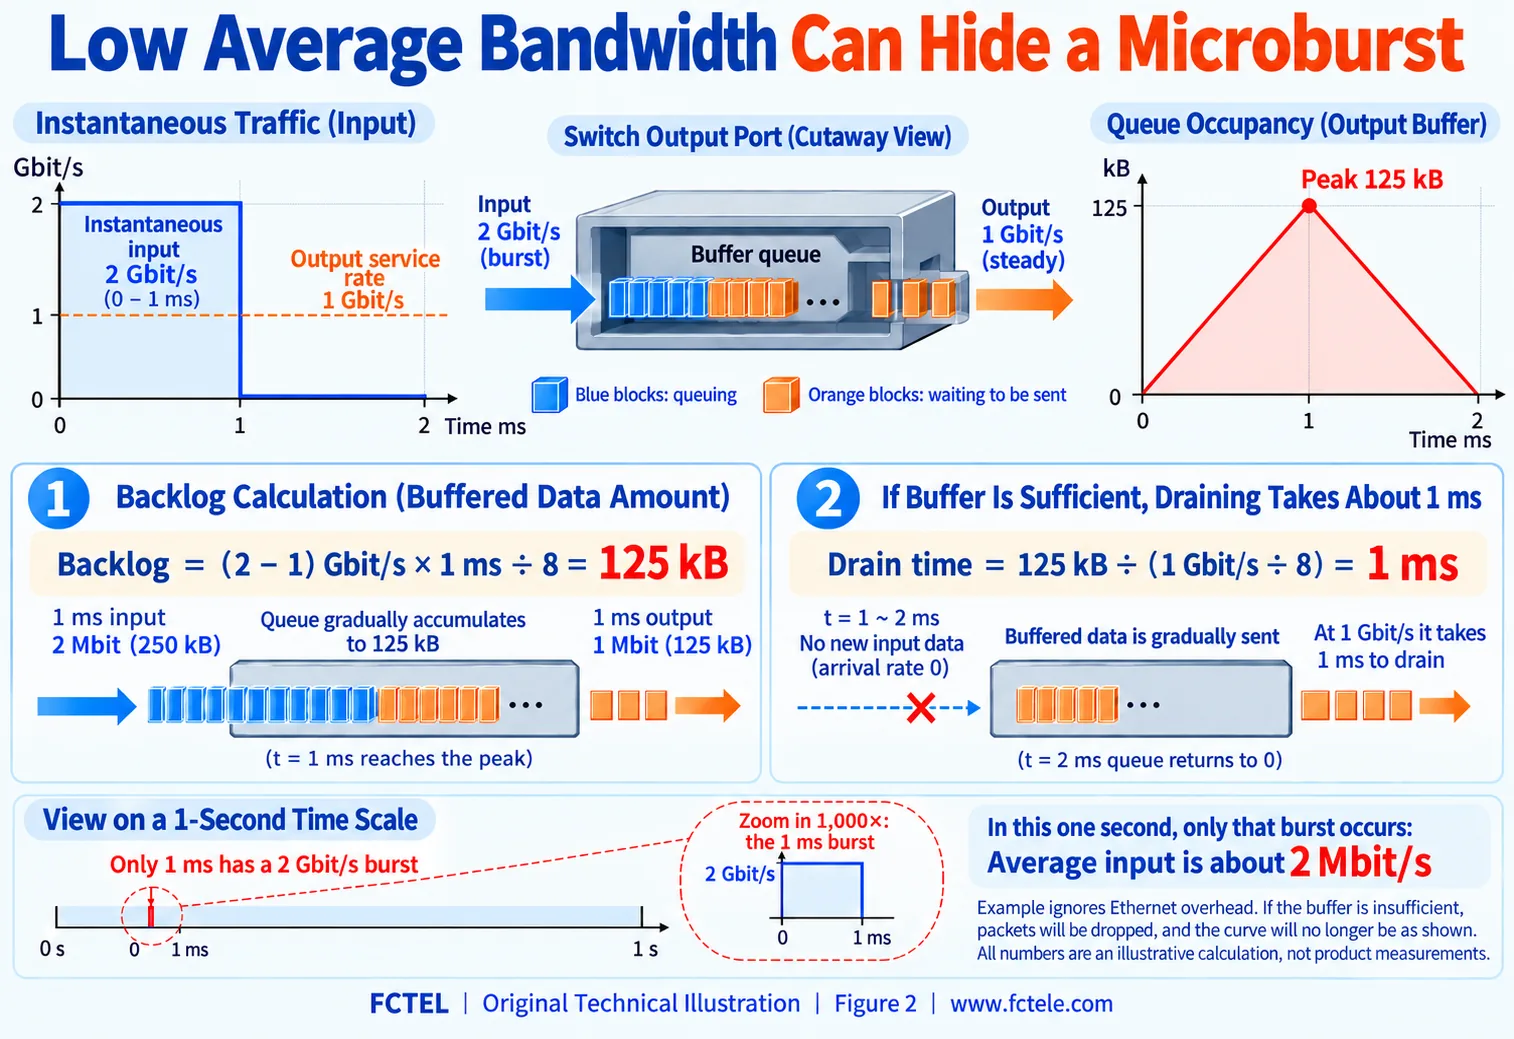
2. Come un microburst sfugge ai grafici di utilizzo medio
Una velocità media è il numero di bit trasmessi diviso per l'intervallo di misurazione. In un intervallo di un secondo, un burst di un millisecondo viene diluito dal tempo di inattività restante. Intervalli più lunghi possono nascondere più facilmente i picchi. Trigger sincronizzati delle telecamere, caricamenti a blocchi e segnalazioni simultanee dei dispositivi possono concentrare il traffico nel tempo. Non esiste un'unica soglia di durata dei microburst applicabile a ogni dispositivo; la condizione rilevante è che il traffico istantaneo in arrivo superi la velocità di servizio dell'uscita.
Consideriamo un calcolo ideale. Due ingressi forniscono complessivamente 2 Gbit/s per 1 ms a una coda inizialmente vuota, mentre l'uscita trasmette a 1 Gbit/s. La differenza è di 1 Gbit/s. Moltiplicando tale differenza per il tempo e dividendo per otto si ottengono 125,000 byte, ovvero circa 125 kB, di dati in attesa. Una volta cessato il traffico in ingresso, il loro smaltimento a 1 Gbit/s richiede circa altri 1 ms. Il grafico triangolare dell'occupazione della coda presuppone un buffer sufficiente e trascura il preambolo, gli intervalli tra frame e il restante traffico.
Se questo è l'unico burst in quel secondo, i dati in arrivo ammontano a 250 kB e la velocità media in ingresso è di soli 2 Mbit/s circa. Tuttavia, il burst richiede un buffer per 125 kB durante il suo intervallo di arrivo di un millisecondo. Se l'allocazione disponibile è inferiore, gli scarti iniziano prima e la curva di occupazione viene troncata dal limite di capacità. Un basso utilizzo medio, quindi, non dimostra l'assenza di congestione istantanea né esclude scarti in uscita.
3. Il buffering assorbe i burst e aggiunge attesa
Un frame in una coda di uscita deve attendere il completamento del lavoro che lo precede. Moltiplicando i byte in coda per otto e dividendo per la velocità di uscita si ottiene una stima del tempo di servizio. Il comportamento effettivo dipende anche dai confini dei frame, dall'overhead del collegamento e dalla schedulazione. Buffer più grandi possono assorbire burst temporanei più lunghi, ma possono anche far attendere più a lungo i frame. Quando il traffico in ingresso supera stabilmente quello in uscita, ogni buffer finito si riempisce prima o poi; uno spazio di memorizzazione aggiuntivo non elimina un deficit persistente di capacità.
Il comportamento all'esaurimento della memoria dipende dall'implementazione e dalle politiche adottate. Il comune meccanismo tail drop rifiuta i nuovi frame in arrivo quando la coda è piena, ma possono essere applicate altre soglie, regole di priorità o meccanismi di scarto anticipato. Non presumere che la strategia di un chip sia quella predefinita per ogni switch industriale. TCP può recuperare i dati tramite conferme di ricezione e ritrasmissioni, mentre l'applicazione subisce un'attesa aggiuntiva. UDP e alcune applicazioni in tempo reale richiedono una propria gestione delle perdite o dei timeout.
Anche il controllo di flusso a livello di collegamento ha dei limiti. Verificare se è abilitato, se il dispositivo remoto risponde, su quale traffico agisce e se propaga il blocco ad altre applicazioni. Abilitare il controllo di flusso non sostituisce la pianificazione della capacità della rete di controllo. Senza una validazione, non si può presumere che i frame di pausa garantiscano il rispetto delle scadenze del PLC.
Aprire l'immagine originale per vedere i dettagli. Scorrere orizzontalmente per leggere le etichette del diagramma a grandezza naturale.
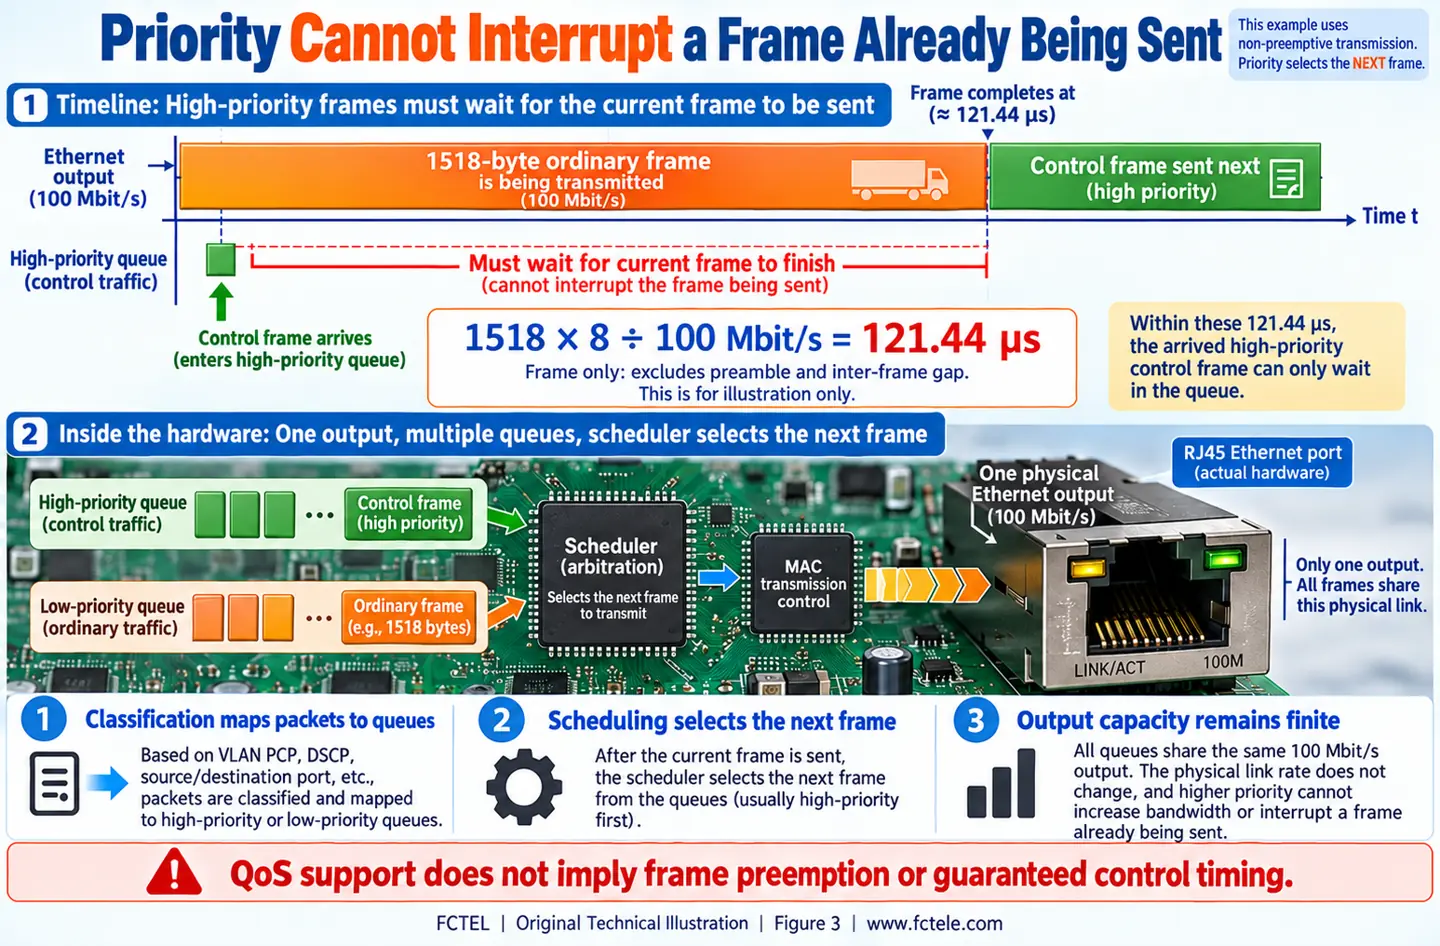
4. Perché la QoS non garantisce un ritardo nullo
La QoS generalmente classifica il traffico utilizzando criteri quali la porta, la priorità IEEE 802.1p o il DSCP IP, lo associa a code interne e affida a uno scheduler la selezione del frame successivo. Una marcatura è un'informazione di classificazione. Senza una mappatura e una schedulazione coerenti lungo il percorso, un frame marcato non riceve necessariamente un servizio preferenziale. La schedulazione a priorità stretta e quella ponderata offrono proprietà di equità diverse. Verificare l'algoritmo, il numero di code e i controlli della velocità per il modello e il firmware specifici.
Con la normale trasmissione senza preemption, un breve frame di controllo può entrare in una coda ad alta priorità dopo che l'uscita ha iniziato a inviare un frame ordinario. Lo scheduler normalmente attende il completamento di quel frame prima di scegliere il frame di controllo. Un frame di 1,518 byte richiede circa 121.44 microsecondi per essere serializzato a 100 Mbit/s, escludendo il preambolo e gli intervalli tra frame. A 1 Gbit/s, lo stesso calcolo limitato al solo frame dà circa 12.144 microsecondi. Si tratta di calcoli illustrativi, non di valori di latenza garantiti per i dispositivi.
La preemption dedicata dei frame Ethernet richiede le relative funzionalità, la configurazione e la cooperazione del dispositivo remoto. Non può essere dedotta da una dichiarazione di supporto alla QoS. Anche il traffico di controllo ad alta priorità può contendersi le risorse con altro traffico di controllo, mentre altre fasi aggiungono attesa. Una progettazione deterministica parte dal ritardo massimo tollerabile e dal carico di picco dell'applicazione, convalida ogni segmento ed evita di assegnare a tutti i frame la priorità più elevata.
5. Distinguere la congestione dagli errori del collegamento fisico
Registrare innanzitutto la velocità della porta e lo stato duplex, i contatori dei byte in ingresso e in uscita, i contatori degli scarti e i contatori degli errori CRC o FCS. Identificare la direzione, l'unità e l'intervallo di aggiornamento di ciascun contatore. Un aumento degli scarti in uscita indica spesso problemi relativi alle risorse o alle politiche di uscita; gli errori CRC richiedono un esame dell'integrità del collegamento in ricezione. Entrambi possono verificarsi contemporaneamente. Un singolo contatore non esclude ogni altra causa. Correlarli con gli istanti in cui si verificano frame applicativi mancanti o timeout.
Migliorare la risoluzione temporale dell'osservazione e, ove supportato, esaminare l'occupazione delle code, i picchi o le categorie di scarto. Se il dispositivo non dispone di queste metriche, utilizzare traffico controllato in un ambiente di prova per confrontare un mittente, due mittenti sincronizzati e invii sfalsati nel tempo. Misurare gli incrementi dei contatori sulla stessa uscita e la risposta dell'applicazione. Una porta mirror ha un proprio limite di capacità: una perdita sul percorso di acquisizione del traffico replicato non equivale automaticamente a una perdita sull'uscita dell'applicazione.
6. Un metodo pratico di collaudo di accettazione per le apparecchiature FCTEL
La documentazione ufficiale FCTEL relativa al suo switch industriale gestito Layer 3 per guida DIN, con quattro porte ottiche da 10 gigabit e otto porte elettriche Gigabit, elenca il funzionamento store-and-forward, la gestione delle code di priorità IEEE 802.1p e DSCP e le statistiche delle porte. Queste funzionalità documentate forniscono un contesto di prodotto per la progettazione e le prove di accettazione. Non attestano il supporto a una specifica funzione di monitoraggio dei microburst, alla preemption dei frame o a una determinata allocazione del buffer per porta. Verificare la configurazione e le statistiche disponibili facendo riferimento al manuale e al firmware corrispondenti.
Individuare il collo di bottiglia effettivo prima di valutare una maggiore capacità in uscita, una riduzione delle velocità istantanee a monte, invii sfalsati e una schedulazione appropriata delle code. L'aggregazione dei collegamenti non garantisce che un singolo flusso applicativo utilizzi simultaneamente tutti i collegamenti membri: verificare l'hashing e la distribuzione del traffico. Dopo le modifiche, ripetere le stesse prove con carico di picco e registrare scarti, attesa, integrità dell'applicazione e ripristino. Dimostrare un miglioramento entro i limiti dell'applicazione di controllo è ciò che rende comprensibili i guasti intermittenti in presenza di un basso utilizzo medio.
Riferimenti tecnici: Cisco: meccanismi dei microburst e monitoraggio specifico della piattaforma. Risorse FCTEL correlate: Articoli tecnici e documentazione di prodotto dello switch industriale (in cinese).
