


BYTE-ESCAPING BEI SERIELLER KOMMUNIKATION
Wie kann ein Begrenzungszeichen zugleich ein Datenwert sein?
Ein serieller Empfänger erkennt Zeichen, während die Anwendung Nachrichten identifizieren muss. SLIP maskiert C0 und DB in den Nutzdaten durch Zwei-Byte-Sequenzen, sodass ein nicht maskiertes END ein Paket begrenzen kann. Der Empfänger kehrt die Zuordnung um und behält dabei seinen Zustand über Lesevorgänge hinweg bei. Diese spezifischen Werte gehören zu SLIP und bieten nicht automatisch Fehlerprüfung oder Sicherheit.
Zeichen und Paket
Eine Zeichengrenze allein kennzeichnet keine Anwendungsnachricht.
Besondere Datenwerte maskieren
SLIP stellt besondere Nutzdatenbytes durch Zwei-Byte-Sequenzen dar.
Zustand beibehalten
Ein Parser muss seinen Escape-Zustand auch dann beibehalten, wenn ein Lesevorgang nach DB endet.
Endpunkte und Schutzumfang zuordnen.
Das tatsächlich verwendete Protokoll und die Einstellungen bestätigen.
Mit autorisierten, unbedenklichen Daten testen.
Checkliste für Auswahl und Überprüfung – aufklappen
Protokoll und Erfassungsebene bestätigen; gewöhnliche und besondere Bytes testen; aufgeteilte Lesevorgänge, doppelte Markierungen und Fehlerbehandlung in einer autorisierten Umgebung überprüfen.
Eine serielle Leitung liefert einen Bytestrom. Woher weiß das empfangende Programm, wo eine Nachricht endet? Ein Ansatz reserviert eine Markierung. Ein Messwert oder eine Datei kann jedoch denselben Bytewert enthalten. Wird er unverändert gesendet, kann er fälschlich als Ende interpretiert werden. Byte-Escaping beseitigt diese Mehrdeutigkeit. Zum Verständnis sollten Zeichenempfang, Paketgrenzen und Anwendungsbedeutung getrennt betrachtet werden, statt nur auf die Baudrate zu schauen.
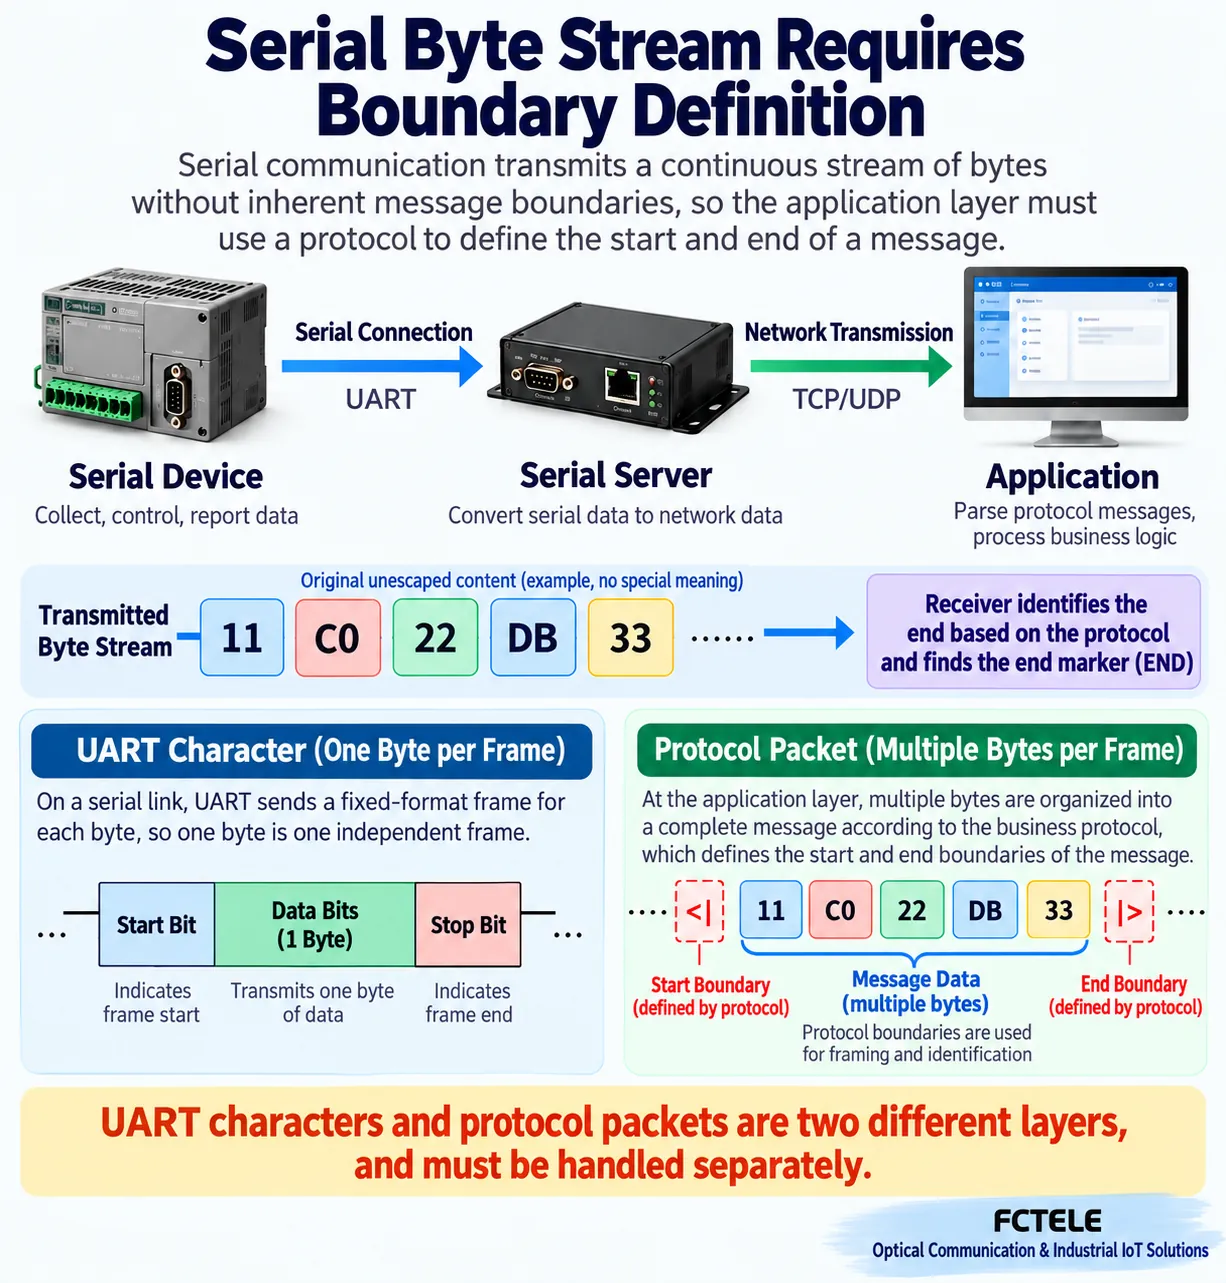
Korrekte Zeichen bilden nicht automatisch ein Paket
Eine übliche asynchrone serielle Schnittstelle verwendet ein Startbit, Datenbits und Stoppbits, um ein Zeichen zu erkennen. Sobald die Zeichen ein Programm erreichen, bilden sie eine Folge von Bytes. Der Empfänger weiß nicht automatisch, wo ein Temperaturmesswert beginnt und endet. Zeichengrenzen und die Grenzen vollständiger Nachrichten sind getrennte Fragestellungen.
Ein Anwendungsprotokoll kann Nachrichten durch eine feste Länge, ein Längenfeld, zeitliche Kriterien oder besondere Markierungen begrenzen. Jeder Ansatz hat Voraussetzungen und erfordert Abwägungen. Dieser Artikel erläutert Markierungen und Maskierung anhand von SLIP als einfachem Beispiel für serielle Rahmung. Er legt weder nahe, dass jedes serielle Protokoll SLIP verwendet, noch dass ein bestehendes Protokoll leichtfertig geändert werden sollte.
Der Einport-Geräteserver FCT-1100-F1S1 von Feichang mit serieller Drei-in-eins-Schnittstelle bietet einen konkreten Kontext für die Anbindung serieller Geräte an Netzwerke. Bytes, die über eine Schnittstelle oder ein Netzwerk weitergeleitet werden, erhalten dadurch nicht automatisch eine neue fachliche Bedeutung. Dieser Artikel zieht keine Rückschlüsse auf das interne Rahmungsprotokoll des Produkts; prüfen Sie dessen tatsächliche Funktionen anhand der Dokumentation und Konfiguration.
Warum eine Markierung zwei Rollen haben kann
Angenommen, beide Endpunkte vereinbaren, dass ein bestimmtes Byte das Ende markiert. Empfängt der Parser dieses Byte, gibt er die zuvor gepufferten Daten weiter. Das Prinzip ähnelt einem Satzzeichen, das das Ende eines Satzes markiert. Binärinhalte können jedoch jeden Bytewert enthalten; kein ausgewählter Wert ist automatisch aus den Nutzdaten ausgeschlossen.
Ein Messdatensatz könnte denselben Wert wie die Endmarkierung enthalten. Soll der Parser dieses Vorkommen als Datenwert oder als Grenze behandeln? Der Wert allein lässt nicht erkennen, welche der beiden Bedeutungen gemeint ist. Sender und Empfänger benötigen eine gemeinsame Regel, die festlegt, wie besondere Werte auf der Leitung anders dargestellt werden.
Einen Wert einfach zu verbieten, schränkt die darstellbaren Originaldaten ein und kann Messwerte unbemerkt verändern. Auch der Austausch von Kupfer durch Glasfaser beseitigt die Mehrdeutigkeit nicht: Die optische Umsetzung verändert das Übertragungsmedium, nicht die Interpretation durch das Anwendungsprotokoll. Verbindungsqualität und Codierungsregeln müssen getrennt geprüft werden.
Maskierung verändert die Darstellung, nicht die Daten
Maskierung lässt sich als Signal verstehen, das folgende Byte nach einer vereinbarten Regel zu interpretieren. Der Sender prüft die Nutzdaten und ersetzt zu maskierende Bytewerte durch besondere Sequenzen. Der Empfänger kehrt diese Zuordnung um und sollte dadurch denselben ursprünglichen Inhalt erhalten.
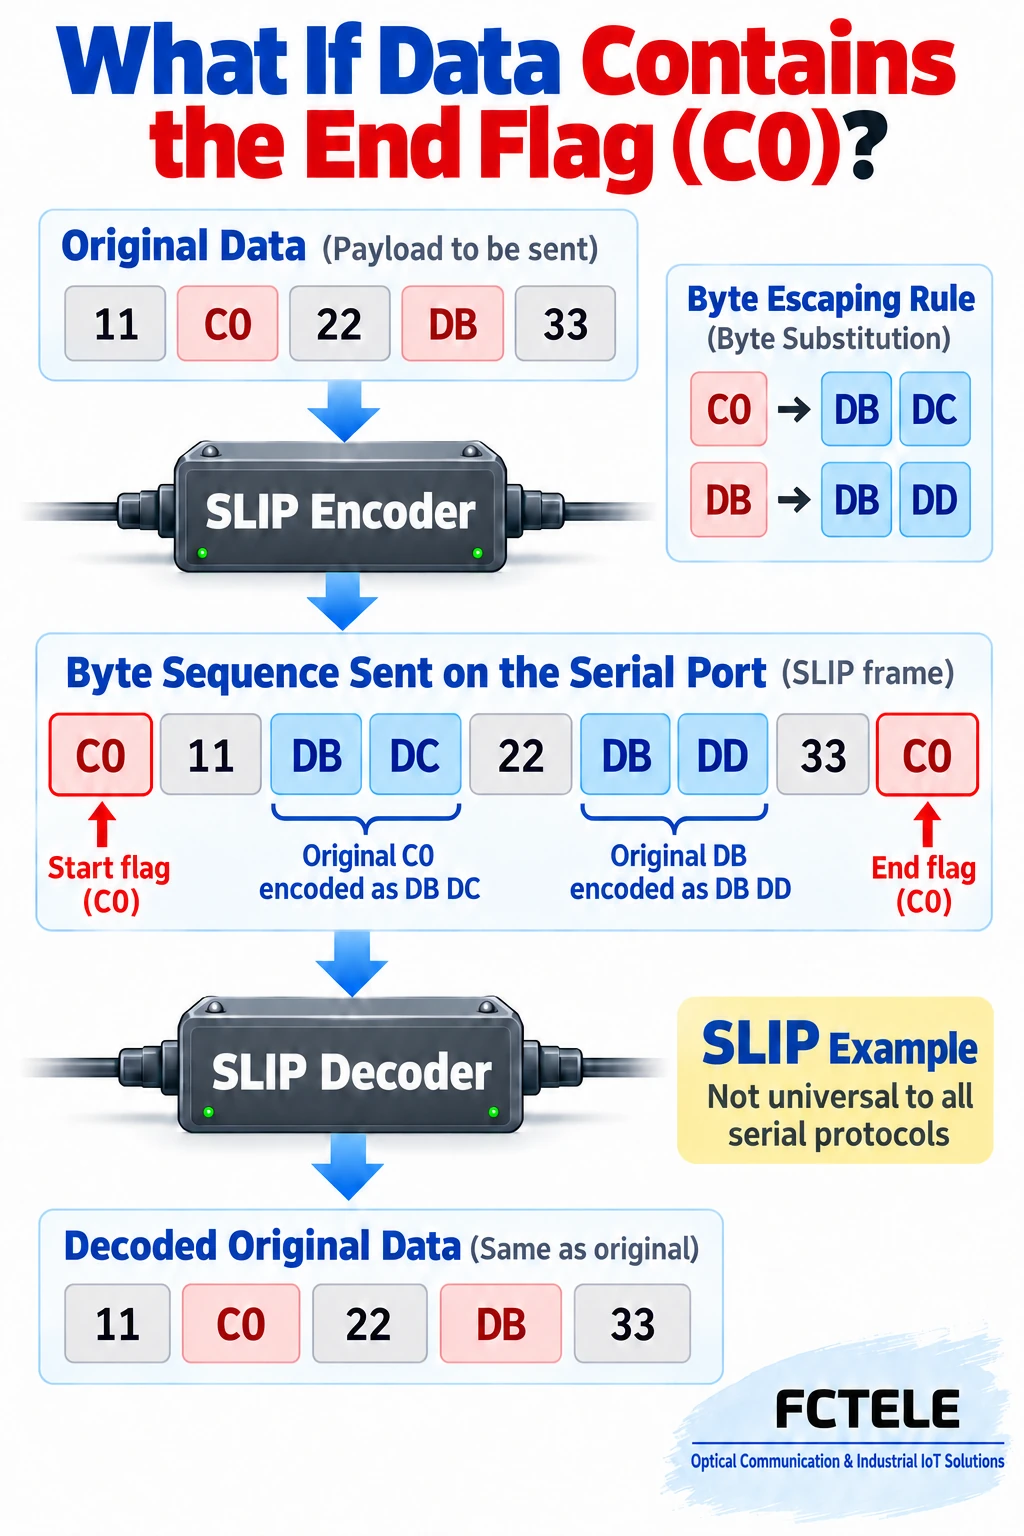
Im SLIP-Beispiel gemäß RFC 1055 steht der Hexadezimalwert C0 für END und DB für ESC. Ein C0 innerhalb der Nutzdaten wird zu DB DC; ein DB innerhalb der Nutzdaten wird zu DB DD. Ein nicht maskiertes C0 bildet die tatsächliche Endgrenze. Diese konkreten Werte gelten für dieses Beispiel, nicht für jedes serielle Protokoll.
Warum wird auch DB maskiert? Es leitet eine besondere Interpretation des nächsten Bytes ein. Würde ein ursprüngliches DB ohne Kennzeichnung gesendet, könnte der nächste gewöhnliche Wert fälschlich als Escape-Suffix interpretiert werden. Durch die Maskierung sowohl des Begrenzungszeichens als auch des Escape-Einleitungsbytes wird eine neue Mehrdeutigkeit vermieden.
Ein kurzes Beispiel vom Sender bis zum Empfänger
Nehmen wir die ursprünglichen Nutzdaten 11 C0 22 DB 33. Die beiden besonderen Werte können nicht direkt als gewöhnlicher Inhalt in den gerahmten Datenstrom eingefügt werden. Die Codierung ergibt 11 DB DC 22 DB DD 33; tatsächliche END-Markierungen begrenzen das Ergebnis, sodass der Empfänger Steuerfunktionen von wiederhergestellten Daten unterscheiden kann.
In dieser Darstellung steht C0 sowohl vor als auch nach dem Paket. RFC 1055 beschreibt das Senden eines END am Anfang als Möglichkeit, angesammelte Stördaten zu verwerfen; ein Ergebnis mit der Länge null aus aufeinanderfolgenden Markierungen sollte nicht als normales IP-Paket weitergegeben werden. Andere Protokolle verwenden nicht unbedingt identische Markierungen an beiden Enden.
Nach der Decodierung werden C0 und DB aus den Nutzdaten wieder zu gewöhnlichen Datenwerten. Die Begrenzungszeichen selbst gehören nicht zum weitergegebenen Inhalt. Die Codierung kann die Anzahl der auf der Leitung übertragenen Bytes erhöhen. Zähler serieller Geräteserver, Mitschnitte und Längenangaben der Anwendung können bei Messungen auf unterschiedlichen Ebenen voneinander abweichen, ohne dass dies einen Datenverlust belegt.
Ein Empfänger muss seinen aktuellen Zustand beibehalten
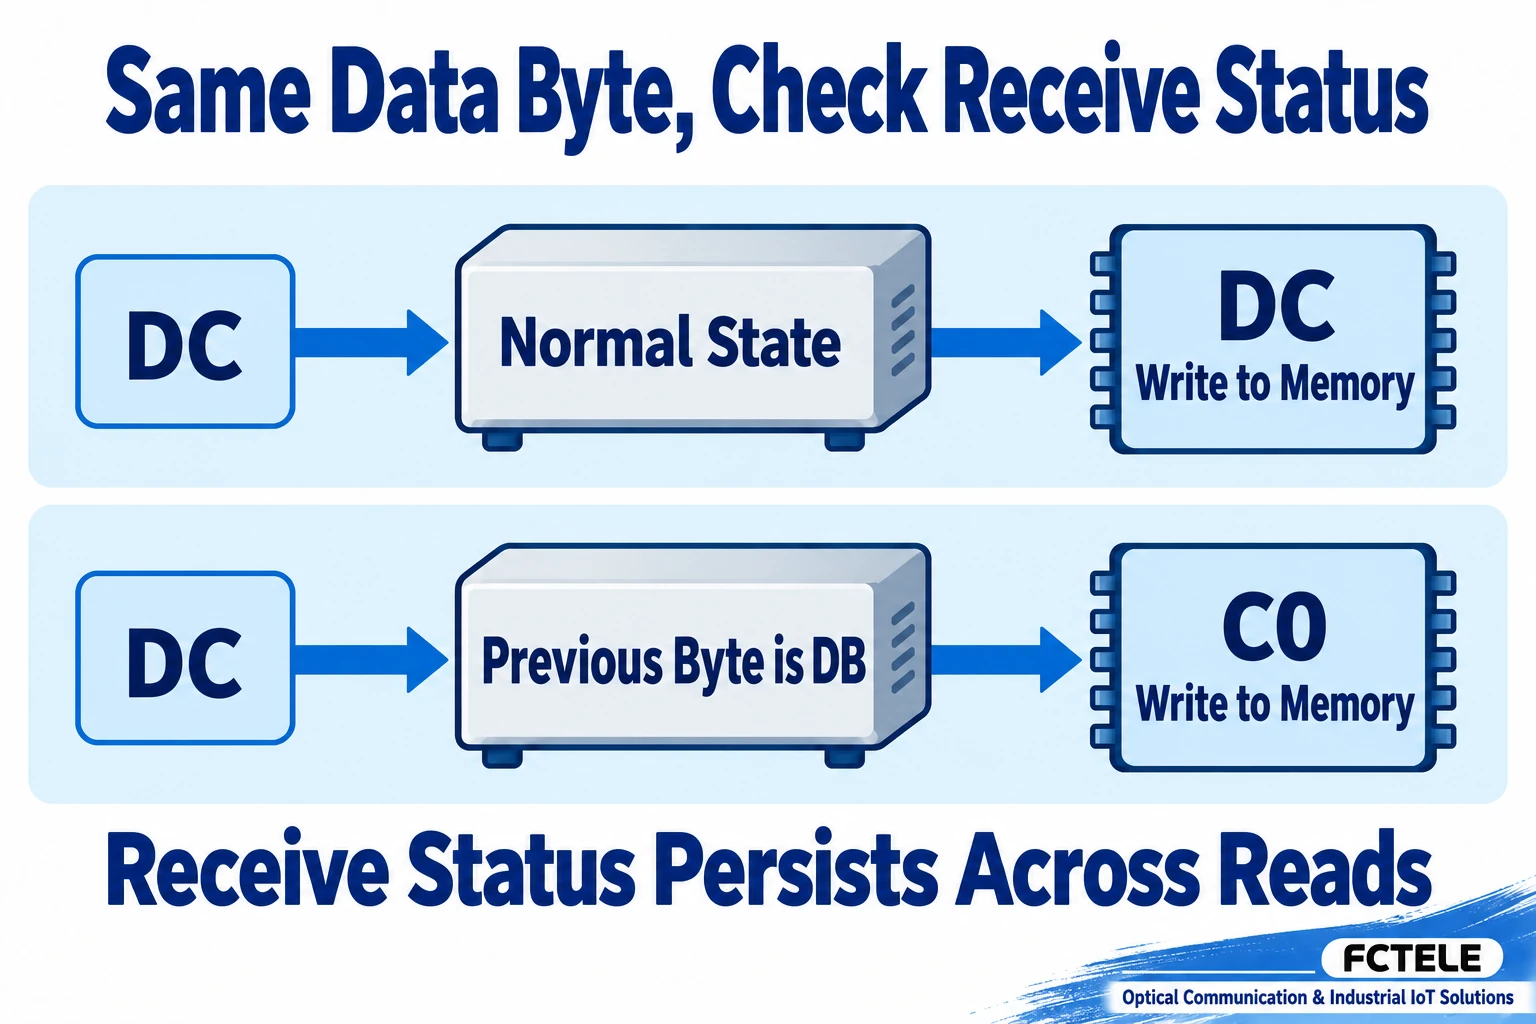
Der Parser kann nicht immer jedes Byte isoliert beurteilen. Er muss zumindest zwischen normalem Lesen und dem Warten auf ein Suffix nach einem Escape-Einleitungsbyte unterscheiden. Im Normalzustand markiert ein END die Paketgrenze; ein DB wechselt in den Wartezustand für das Suffix, statt DB sofort als ursprünglichen Datenwert auszugeben.
Im Wartezustand wendet der Empfänger die vereinbarte Zuordnung an und kehrt in den Normalzustand zurück. Die Beziehung zwischen zwei Bytes wird durch den Parserzustand aufrechterhalten; die Bytes müssen nicht im selben Software-Lesevorgang eintreffen. Endet ein Lesevorgang mit DB und beginnt der nächste mit DC, muss der Empfänger seinen Zustand beibehalten und die Umwandlung abschließen.
Eine reale Implementierung benötigt außerdem Regeln für ungültige Suffixe, Puffergrenzen, leere Pakete und Unterbrechungen. Dieser Artikel schreibt keine universelle Fehlerstrategie vor. Wenn die Software den Parserzustand bei jedem Netzwerk-Lesevorgang zurücksetzt oder jeden Lesevorgang als Nachricht betrachtet, kann die Rahmung fehlschlagen, obwohl die Transportschicht alle Bytes geliefert hat.
Eine Grenze ist weder eine Fehlerprüfung noch eine Sicherheitsgarantie
Maskierung beseitigt Mehrdeutigkeiten in der Darstellung. Sie ergänzt nicht automatisch Fehlererkennung, erneute Übertragung, Authentifizierung oder Verschlüsselung. Die Aufteilung eines Datenstroms in Pakete beweist weder, dass jedes Paket korrekt ist, noch dass sein Absender vertrauenswürdig ist. SLIP selbst bietet nur begrenzte Funktionen und sollte nicht als allgemeines Sicherheitsprotokoll für industrielle Steuerungssysteme betrachtet werden.
Verschiedene Protokolle können Prüfungen und Maskierung auch in unterschiedlichen Verarbeitungsschritten anwenden. Die HDLC-ähnliche Rahmung von PPP hat eigene Regeln für Flags, Transparenz und Rahmenprüfung; diese Details sind nicht mit SLIP identisch. Werden Markierungswerte, Escape-Suffixe oder Prüfschritte vermischt, können beide Seiten Bytes empfangen, ohne dass eine von ihnen ein Paket akzeptiert.
Ordnen Sie die ursprünglichen Anwendungsdaten, Codierung, physische oder netzwerkbasierte Übertragung, Decodierung und Anwendungsvalidierung den jeweiligen Stellen im Ablauf zu. Bestimmen Sie bei der Fehleranalyse zunächst die Beobachtungsebene, bevor Sie die erwarteten Inhalte vergleichen. Ein direkter Byte-für-Byte-Vergleich von codiertem Datenverkehr mit decodierten Anwendungsfeldern kann einen Fehler vortäuschen, der gar nicht vorliegt.
Die vereinbarten Regeln mit kleinen, reproduzierbaren Testdaten prüfen
Beginnen Sie mit der Geräte- und Protokolldokumentation. Dokumentieren Sie Versionen, Schnittstelleneinstellungen, Paketbildung und Erfassungspunkte. Testen Sie gewöhnliche Daten, Daten mit dem Endwert, Daten mit dem Escape-Wert und aufeinanderfolgende besondere Werte. Prüfen Sie sowohl die codierte als auch die decodierte Form. Dies sind beispielhafte Methoden, keine Behauptung, dass ein bestimmtes Produkt vermessen wurde.
Testen Sie anschließend aufgeteilte Lesevorgänge, Lesevorgänge mit zusammengefassten Daten und unterbrochene Verbindungen, soweit die Implementierung diese Fälle behandeln muss. Verwenden Sie harmlose Daten in einer autorisierten Umgebung und setzen Sie Beispielbytes nicht als Befehle im laufenden Produktionsbetrieb ein. Wenn die Endpunkte unterschiedliche Protokolle verwenden, klären Sie vor wiederholten Änderungen der Baudrate, welche Instanz die Umsetzung übernimmt.
Beachten Sie die Ebenen: Der UART erkennt Zeichen, eine Rahmungsregel erkennt Nachrichten, und Maskierung verhindert, dass besondere Nutzdatenwerte mit Steuermarkierungen verwechselt werden. Diese Trennung erklärt, warum ein Port Bytes empfangen kann, während eine Anwendung dennoch keine vollständige Nachricht rekonstruieren kann.
Primärquellen
RFC 1055: SLIP, Juni 1988, kein Internetstandard; RFC 1662: PPP mit HDLC-ähnlicher Rahmung, Juli 1994. Produktkontext: Serieller Geräteserver FCT-1100-F1S1; damit wird nicht behauptet, dass es SLIP verwendet.
Übersetzt aus dem chinesischen Fachartikel: Chinesischen Originalartikel lesen.
Häufige Praxisfragen
Wird durch den Empfang serieller Zeichen automatisch ein Paket erkannt?
Nein. Der Zeichenempfang durch den UART und die Rahmung auf Anwendungsebene sind getrennte Vorgänge; beide Endpunkte benötigen dieselben Rahmungsregeln.
Wie maskiert SLIP C0 und DB in den Nutzdaten?
C0 in den Nutzdaten wird zu DB DC und DB in den Nutzdaten zu DB DD; ein nicht maskiertes END kennzeichnet eine Grenze. Andere Protokolle können andere Regeln verwenden.
Ersetzt Byte-Escaping Integritätsprüfungen oder Verschlüsselung?
Nein. Es beseitigt die Mehrdeutigkeit zwischen Steuermarkierungen und Nutzdatenwerten; es bietet nicht automatisch Fehlererkennung, erneute Übertragung, Authentifizierung oder Verschlüsselung.
Geltungsbereich und weiterführende Literatur
Allgemeines Beispiel für SLIP-Rahmung, keine Aussage über ein bestimmtes Produkt oder gemessene Daten.
TCP-Half-Close und serielle Antworten · RS485-Einheitslasten und Treiberbudget
