


ESCAPE DE BYTES SERIE
¿Cómo puede un delimitador ser también un dato?
Un receptor serie recibe caracteres, mientras que la aplicación debe identificar mensajes. SLIP aplica escape a C0 y DB de la carga útil mediante secuencias de dos bytes para que END sin escape pueda delimitar un paquete. El receptor invierte la correspondencia y conserva su estado entre lecturas. Estos valores específicos pertenecen a SLIP y no proporcionan automáticamente comprobación de errores ni seguridad.
Carácter frente a paquete
El límite de un carácter por sí solo no identifica un mensaje de aplicación.
Aplicar escape a los datos especiales
SLIP representa los bytes especiales de la carga útil mediante secuencias de dos bytes.
Conservar el estado
Un analizador debe conservar su estado de escape incluso cuando una lectura termina después de DB.
Identificar los extremos y el alcance.
Confirmar el protocolo y los ajustes reales.
Realizar pruebas con datos inocuos y autorización.
Lista de comprobación para la selección y la verificación — desplegar
Confirme el protocolo y la capa de captura; pruebe bytes ordinarios y especiales; verifique las lecturas divididas, los marcadores duplicados y la gestión de errores en un entorno autorizado.
Una línea serie entrega un flujo de bytes. ¿Cómo sabe el programa receptor dónde termina un mensaje? Un método consiste en reservar un marcador. Sin embargo, una medición o un archivo pueden contener el mismo valor de byte, y enviarlo sin cambios puede hacer que se confunda con un final. El escape de bytes resuelve esa ambigüedad. Para entenderlo, distinga entre la recepción de caracteres, los límites de los paquetes y el significado para la aplicación, en lugar de fijarse únicamente en la velocidad en baudios.
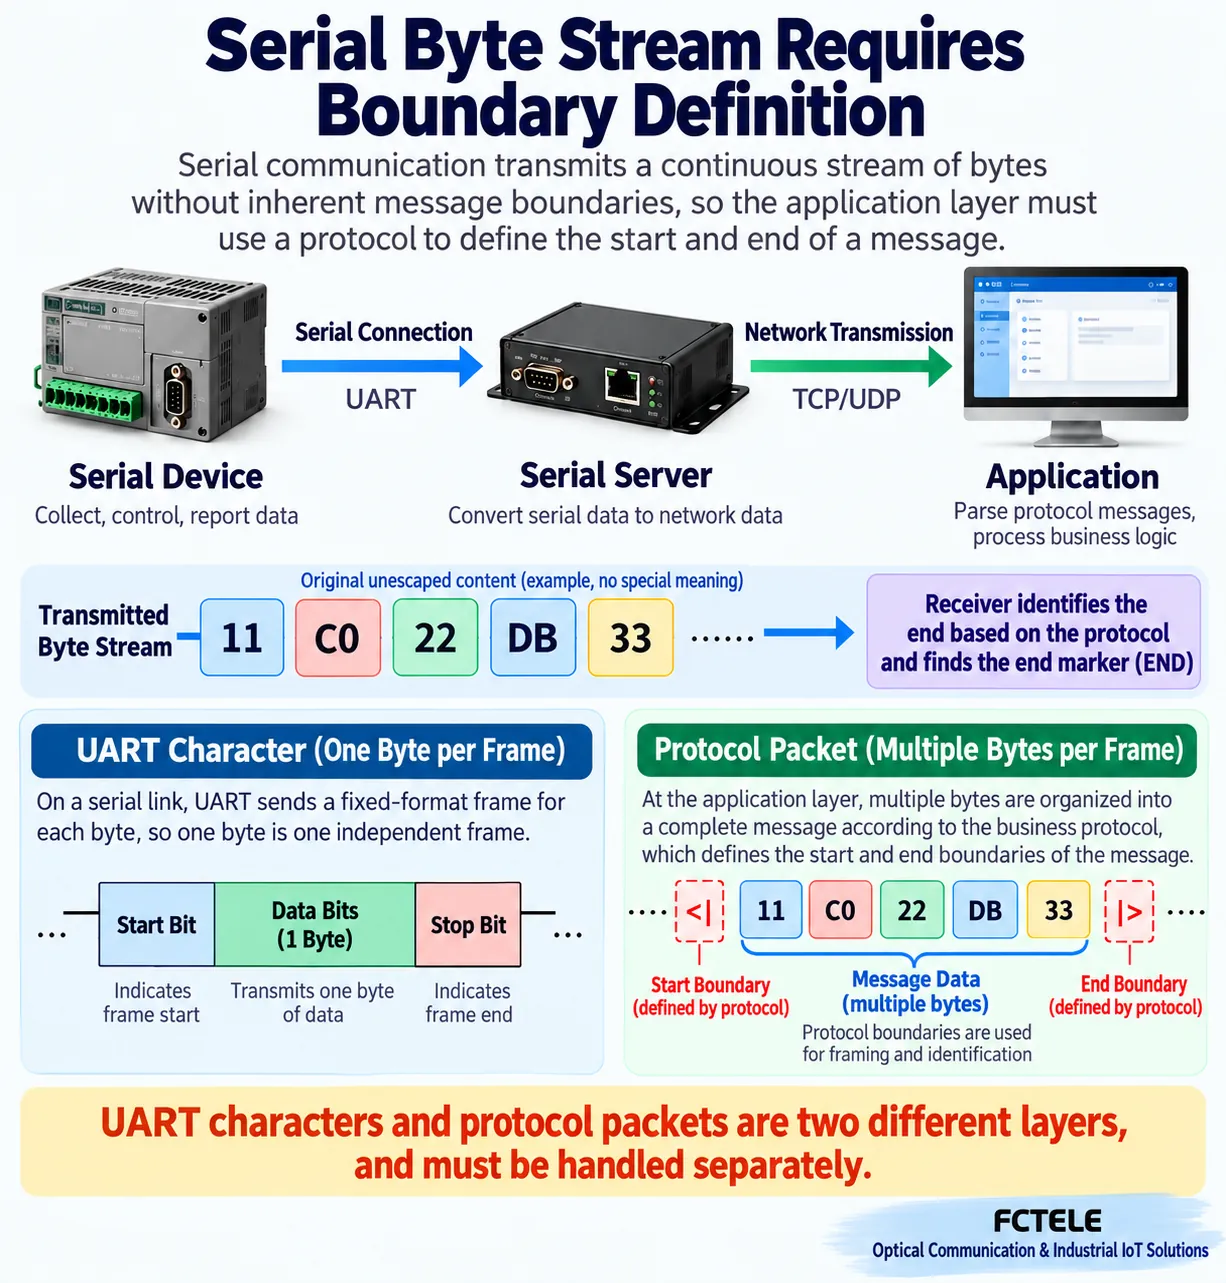
Los caracteres correctos no forman automáticamente un paquete
Una interfaz serie asíncrona habitual utiliza un bit de inicio, bits de datos y bits de parada para identificar un carácter. Una vez que los caracteres llegan a un programa, forman una secuencia de bytes. El receptor no sabe automáticamente dónde empieza y termina una lectura de temperatura. Los límites de los caracteres y los de los mensajes completos son problemas distintos.
Un protocolo de aplicación puede utilizar una longitud fija, un campo de longitud, criterios temporales o marcadores especiales para delimitar mensajes. Cada opción tiene sus condiciones y compromisos. Este artículo utiliza SLIP, un ejemplo sencillo de entramado serie, para explicar los marcadores y el escape. No sugiere que todos los protocolos serie utilicen SLIP ni que deba modificarse un protocolo existente a la ligera.
El servidor de dispositivos serie tres en uno de un solo puerto FCT-1100-F1S1 de Feichang ofrece un contexto real de comunicación entre serie y red. Los bytes reenviados a través de una interfaz o una red no adquieren automáticamente un nuevo significado de negocio. Este artículo no deduce el protocolo de entramado interno del producto; consulte la documentación y la configuración para conocer sus capacidades reales.
Por qué un marcador puede tener dos funciones
Supongamos que ambos extremos acuerdan que un byte determinado marca el final. Al recibirlo, un analizador entrega los datos anteriores almacenados en el búfer. La idea se asemeja a un signo de puntuación que marca el final de una oración. Sin embargo, el contenido binario puede contener cualquier valor de byte; ningún valor elegido queda automáticamente excluido de la carga útil.
Un registro de medición podría contener el mismo valor que el marcador de fin. ¿Debe el analizador tratar esa aparición como un dato o como un límite? El valor por sí solo no permite resolver ambas cuestiones. El emisor y el receptor necesitan una regla compartida que cambie la representación de los valores especiales en la línea.
Prohibir sin más un valor restringe lo que pueden expresar los datos originales y puede alterar las mediciones sin advertencia. Sustituir el cobre por fibra tampoco elimina la ambigüedad: la conversión óptica cambia el medio de transmisión, no la interpretación del protocolo de aplicación. La calidad del enlace y las reglas de codificación deben comprobarse por separado.
El escape cambia la representación, no los datos
El escape puede entenderse como una señal para interpretar el byte siguiente según una regla acordada. El emisor examina la carga útil y sustituye los valores de byte protegidos por secuencias especiales. El receptor invierte la correspondencia y debería obtener el mismo contenido original.
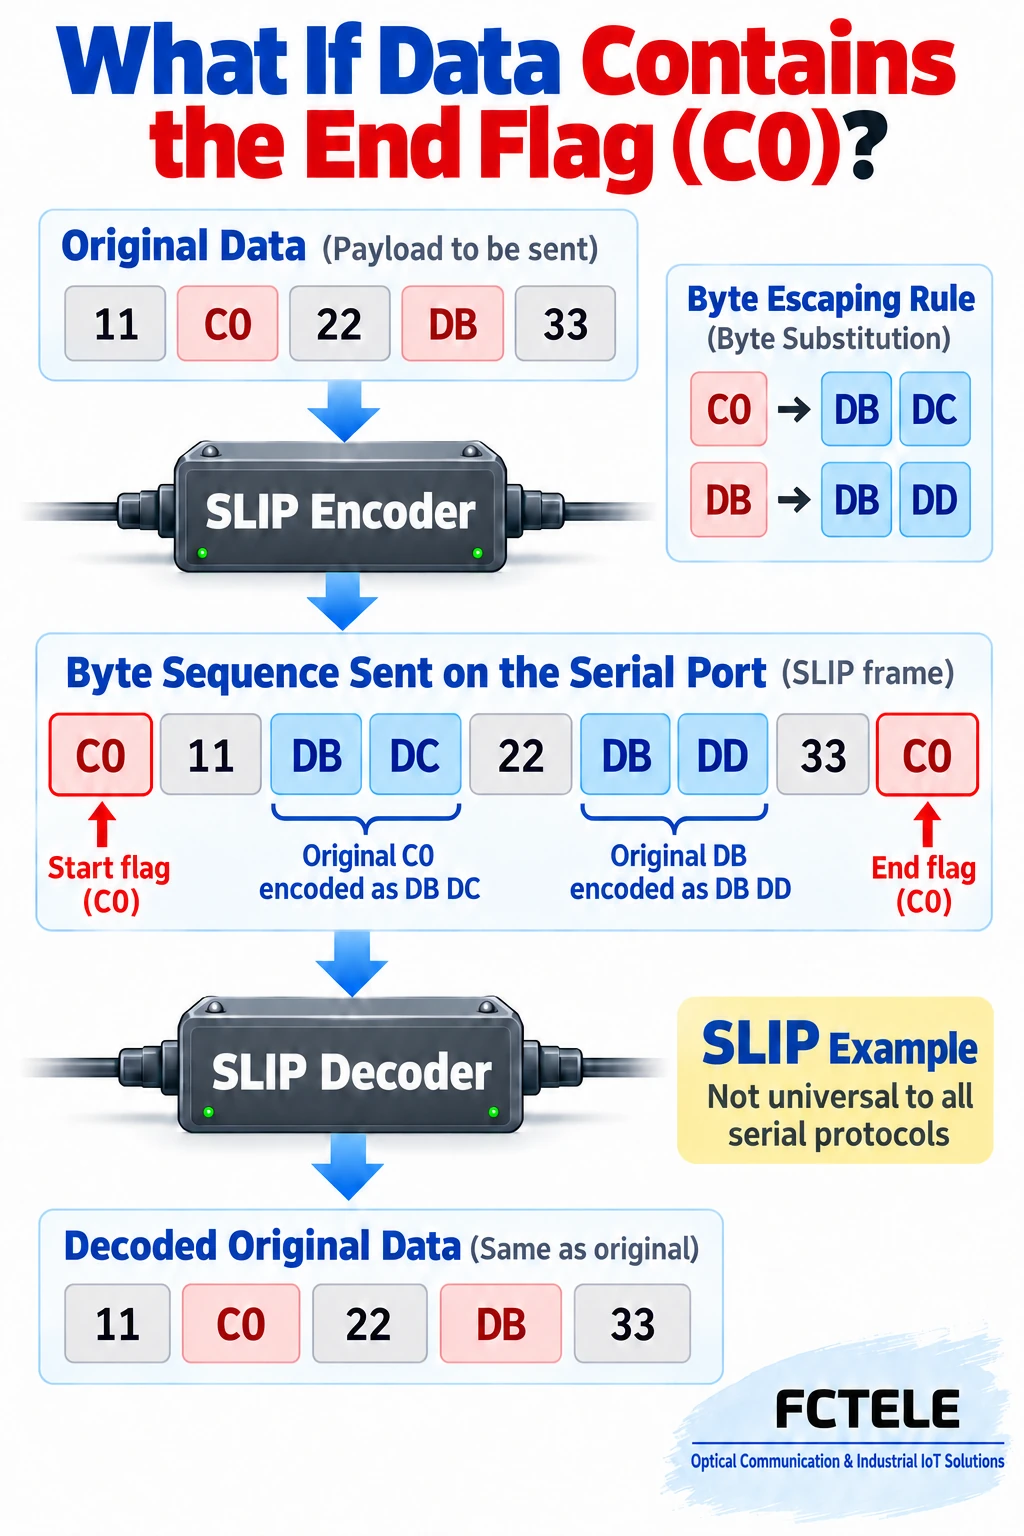
En el ejemplo de SLIP descrito en RFC 1055, el valor hexadecimal C0 es END y DB es ESC. Un C0 dentro de la carga útil se convierte en DB DC; un DB dentro de la carga útil se convierte en DB DD. Un C0 sin escape establece el límite de fin real. Estos valores concretos pertenecen a este ejemplo, no a todos los protocolos serie.
¿Por qué aplicar escape también a DB? Este byte introduce una interpretación especial del byte siguiente. Si un DB original se enviara sin distinguirlo, el siguiente valor ordinario podría confundirse con un sufijo de escape. Proteger tanto el delimitador como el byte que introduce el escape evita crear una nueva ambigüedad.
Siga un breve ejemplo del emisor al receptor
Tomemos la carga útil original 11 C0 22 DB 33. Los dos valores especiales no pueden colocarse directamente en el flujo entramado como contenido ordinario. La codificación produce 11 DB DC 22 DB DD 33; los marcadores END reales delimitan el resultado para que el receptor pueda distinguir las funciones de control de los datos restaurados.
Esta ilustración coloca C0 tanto antes como después del paquete. RFC 1055 describe el envío de un END al inicio como forma de eliminar el ruido acumulado; un resultado de longitud cero generado por marcadores consecutivos no debe entregarse como un paquete IP normal. Otros protocolos no utilizan necesariamente marcadores idénticos en ambos extremos.
Tras la decodificación, C0 y DB de la carga útil vuelven a ser datos ordinarios. Los propios delimitadores no forman parte del contenido entregado. La codificación puede aumentar el número de bytes transmitidos por la línea. Los contadores del servidor serie, las capturas y las longitudes de aplicación pueden diferir si se miden en capas distintas, sin que ello demuestre una pérdida de datos.
Un receptor debe recordar su estado actual
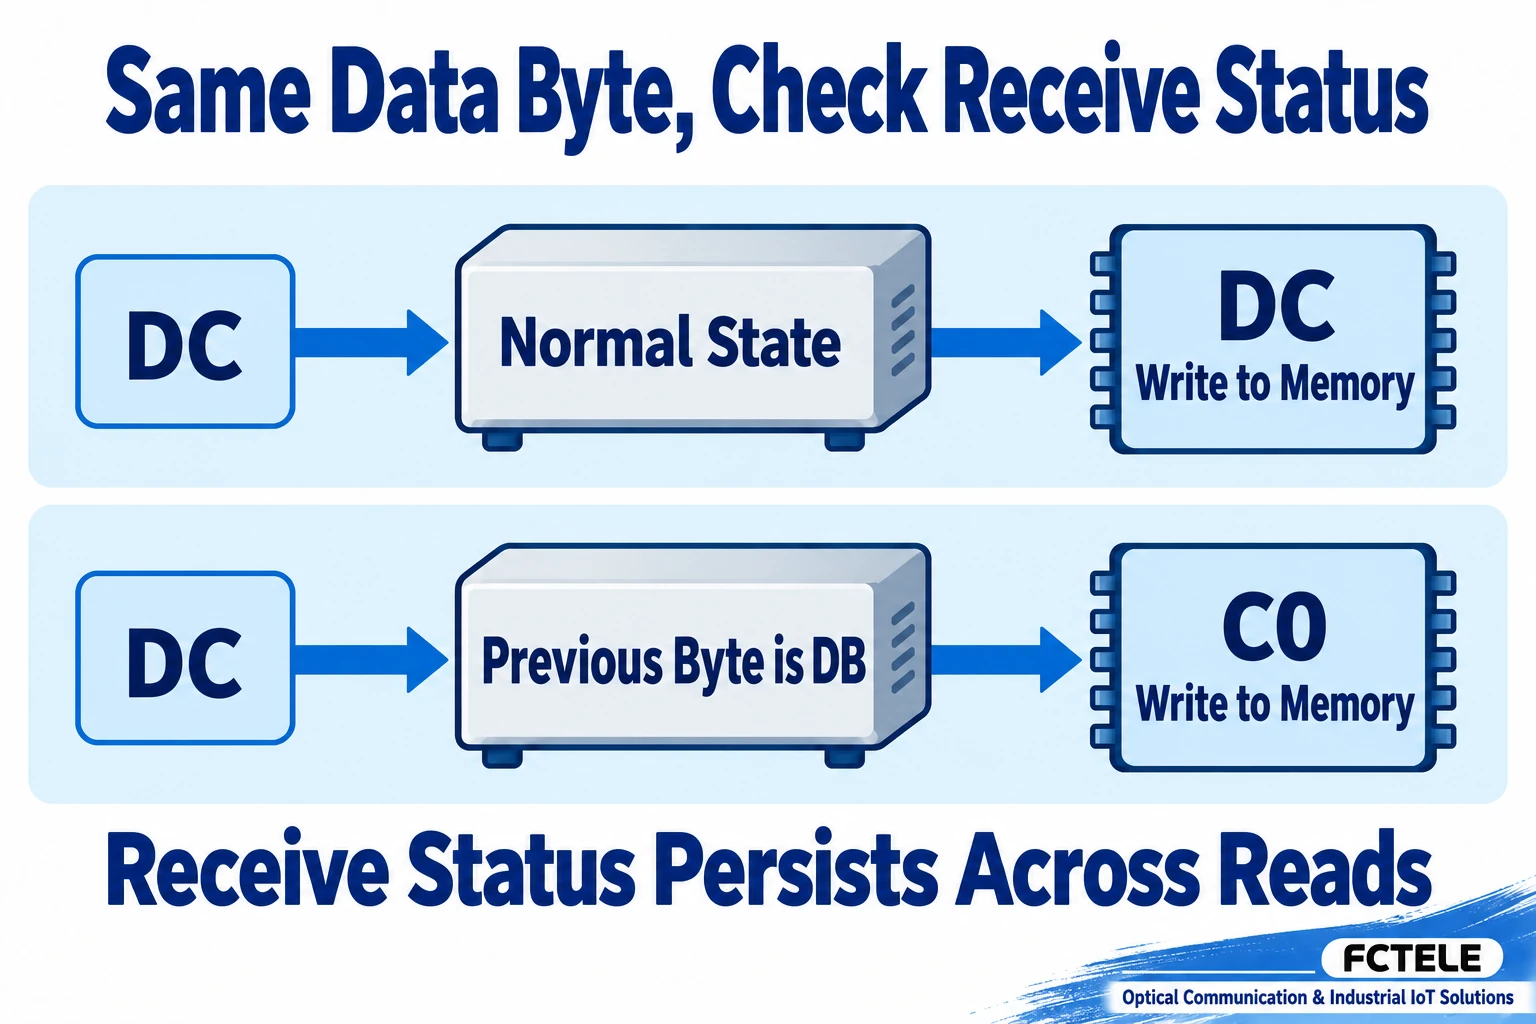
El analizador no siempre puede decidir cómo tratar cada byte de forma aislada. Como mínimo, debe distinguir entre la lectura normal y la espera de un sufijo después de un byte que introduce un escape. En estado normal, un END marca el límite del paquete; un DB cambia el estado a espera del sufijo, en lugar de emitir inmediatamente DB como dato original.
En el estado de espera, el receptor aplica la correspondencia acordada y vuelve al estado normal. La relación entre dos bytes se mantiene mediante el estado del analizador; no es necesario que los bytes lleguen en la misma lectura del software. Si una lectura termina con DB y la siguiente empieza con DC, el receptor debe conservar el estado y completar la conversión.
Una implementación real también necesita reglas para los sufijos no válidos, los límites del búfer, los paquetes vacíos y las interrupciones. Este artículo no impone una estrategia universal de gestión de errores. Si el software borra el estado de análisis en cada lectura de red, o supone que cada lectura es un mensaje, el entramado puede fallar aunque el transporte haya entregado todos los bytes.
Un límite no es una comprobación de errores ni una garantía de seguridad
El escape resuelve la ambigüedad de representación. No añade automáticamente detección de errores, retransmisión, autenticación ni cifrado. Dividir un flujo en paquetes no demuestra que cada paquete sea correcto ni que su emisor sea de confianza. SLIP por sí mismo ofrece servicios limitados y no debe considerarse un protocolo de seguridad de uso general para el control industrial.
Los distintos protocolos también pueden aplicar comprobaciones y escape en etapas diferentes. El entramado de tipo HDLC de PPP tiene sus propias reglas de indicador, transparencia y comprobación de tramas; esos detalles no son idénticos a los de SLIP. Mezclar valores de marcadores, sufijos de escape o etapas de comprobación puede hacer que ambos extremos reciban bytes sin que ninguno acepte un paquete.
Identifique dónde se sitúan los datos originales de la aplicación, la codificación, el transporte físico o de red, la decodificación y la validación de la aplicación. Al investigar errores, identifique la capa de observación antes de comparar el contenido esperado. Una comparación directa, byte a byte, del tráfico codificado con los campos de aplicación decodificados puede crear un fallo aparente que no existe.
Compruebe las reglas acordadas con muestras pequeñas y repetibles
Empiece por la documentación del dispositivo y del protocolo. Registre las versiones, los ajustes de la interfaz, la paquetización y los puntos de captura. Pruebe datos ordinarios, datos que contengan el valor de fin, datos que contengan el valor de escape y valores especiales consecutivos. Compruebe tanto las formas codificadas como las decodificadas. Son métodos ilustrativos, no una afirmación de que se haya medido un producto concreto.
Después, pruebe las lecturas divididas, las lecturas agrupadas y las conexiones interrumpidas cuando la implementación deba gestionarlas. Utilice datos inocuos en un entorno autorizado, no bytes de ejemplo como comandos en un sistema de producción activo. Si los extremos utilizan protocolos diferentes, determine quién realiza la conversión antes de cambiar repetidamente las velocidades en baudios.
Recuerde las capas: UART identifica los caracteres, una regla de entramado identifica los mensajes y el escape evita que los valores especiales de la carga útil se confundan con marcadores de control. Distinguirlas explica por qué un puerto puede recibir bytes mientras una aplicación sigue sin poder reconstruir un mensaje completo.
Referencias principales
RFC 1055: SLIP, junio de 1988, no es un estándar de Internet; RFC 1662: PPP con entramado de tipo HDLC, julio de 1994. Contexto del producto: Servidor de dispositivos serie FCT-1100-F1S1; esto no afirma que utilice SLIP.
Traducido del artículo técnico en chino: Leer el artículo original en chino.
Preguntas prácticas frecuentes
¿La recepción de caracteres serie identifica automáticamente un paquete?
No. La recepción de caracteres UART y el entramado de la aplicación son procesos distintos; ambos extremos necesitan las mismas reglas de entramado.
¿Cómo aplica SLIP escape a C0 y DB de la carga útil?
C0 de la carga útil se convierte en DB DC y DB de la carga útil se convierte en DB DD; END sin escape indica un límite. Otros protocolos pueden utilizar reglas diferentes.
¿El escape de bytes sustituye a las comprobaciones de integridad o al cifrado?
No. Elimina la ambigüedad entre los marcadores de control y los valores de la carga útil; no proporciona automáticamente detección de errores, retransmisión, autenticación ni cifrado.
Alcance y lecturas adicionales
Ejemplo genérico de entramado SLIP, no una afirmación sobre un producto específico ni sobre datos medidos.
Semicierre de TCP y respuestas serie · Cargas unitarias de RS485 y presupuesto de carga del controlador de línea
