ネットワーク機器の障害箇所を特定する方法:物理リンクからルーティング、アプリケーションまで
閲覧数: 89 +2FCTELEによるオリジナル記事著者:FCTELE技術チーム
概要設定変更や機器の再起動を行う前に、ネットワーク障害の切り分けはどこから始めるべきですか?
影響を受けている利用者、問題の発生時刻、および同じ経路に関係する最近の変更を記録します。そのうえで、対象を絞った許可済みのテストを使い、物理的な安定性、レイヤー2の転送、IPの到達性、アプリケーションの動作を切り分けます。pingの失敗はハードウェアが機能していない証拠ではなく、pingの成功もアプリケーションの受け入れ確認にはなりません。一時的な復旧によって原因特定に必要な証拠が失われないよう、ログとカウンターを保存してください。
3つの仕組みと検証の適用範囲信号の流れを追い、実際のサービスを検証する
01時刻と影響範囲を記録して保持する
カウンターの増加とイベント記録を時刻で照合すると、影響区間を絞り込めます。
02往路と復路を確認する
サブネットをまたぐサービスには、有効なネクストホップと、応答が許可されていることが必要です。
03待ち受け中のサービスを確認する
ホストに到達できても、アプリケーションが正常に機能していない、またはその利用が許可されていない場合があります。
スワイプして3つの図を比較 →
概念を説明するための図であり、実測波形、設置配線図、特定製品の内部構成を示すものではありません。- 01
時刻と影響範囲を記録して保持する再起動で有用な履歴が消える前に、状態を記録してください。
- 02
往路と復路を確認するマスク、ゲートウェイ、経路、ポリシーを双方向で確認してください。
- 03
待ち受け中のサービスを確認する対象となるユーザー操作に沿って、待ち受け状態、ログ、依存先を確認してください。
選定・検証チェックリスト確認項目と関連ガイドを展開する
ネットワーク障害は、物理リンク、レイヤー2の転送、IPの経路、アプリケーションサービスの順に、層ごとに特定する必要があります。ルーター、スイッチ、サーバー、トランシーバーはそれぞれ役割が異なるため、すべてを「とりあえず再起動」で対処することはできません。まず影響範囲と発生時刻を記録し、対象を絞ったテストによって、アプリケーションの問題を光ファイバーや機器の故障と取り違えないようにします。
最初の確認:誰が影響を受け、いつ発生したか
端末1台だけに異常がある場合と、フロア全体や拠点全体に異常がある場合では、確認の方向性が異なります。正常な機器と異常な機器の接続箇所を比較し、配線、電源、設定、ソフトウェアに変更がなかったかを確認します。症状、エラーメッセージ、時刻を記録してください。これらの情報は、共通するノードの特定に役立ちます。
証拠を収集する前に、すべての機器を繰り返し再起動しないでください。再起動によってカウンターがクリアされたり、問題が一時的に隠れたりすることはありますが、原因を説明することはできません。本番システムでは、まず影響を評価し、既存の設定とログを保全したうえで、必要な作業を計画する必要があります。
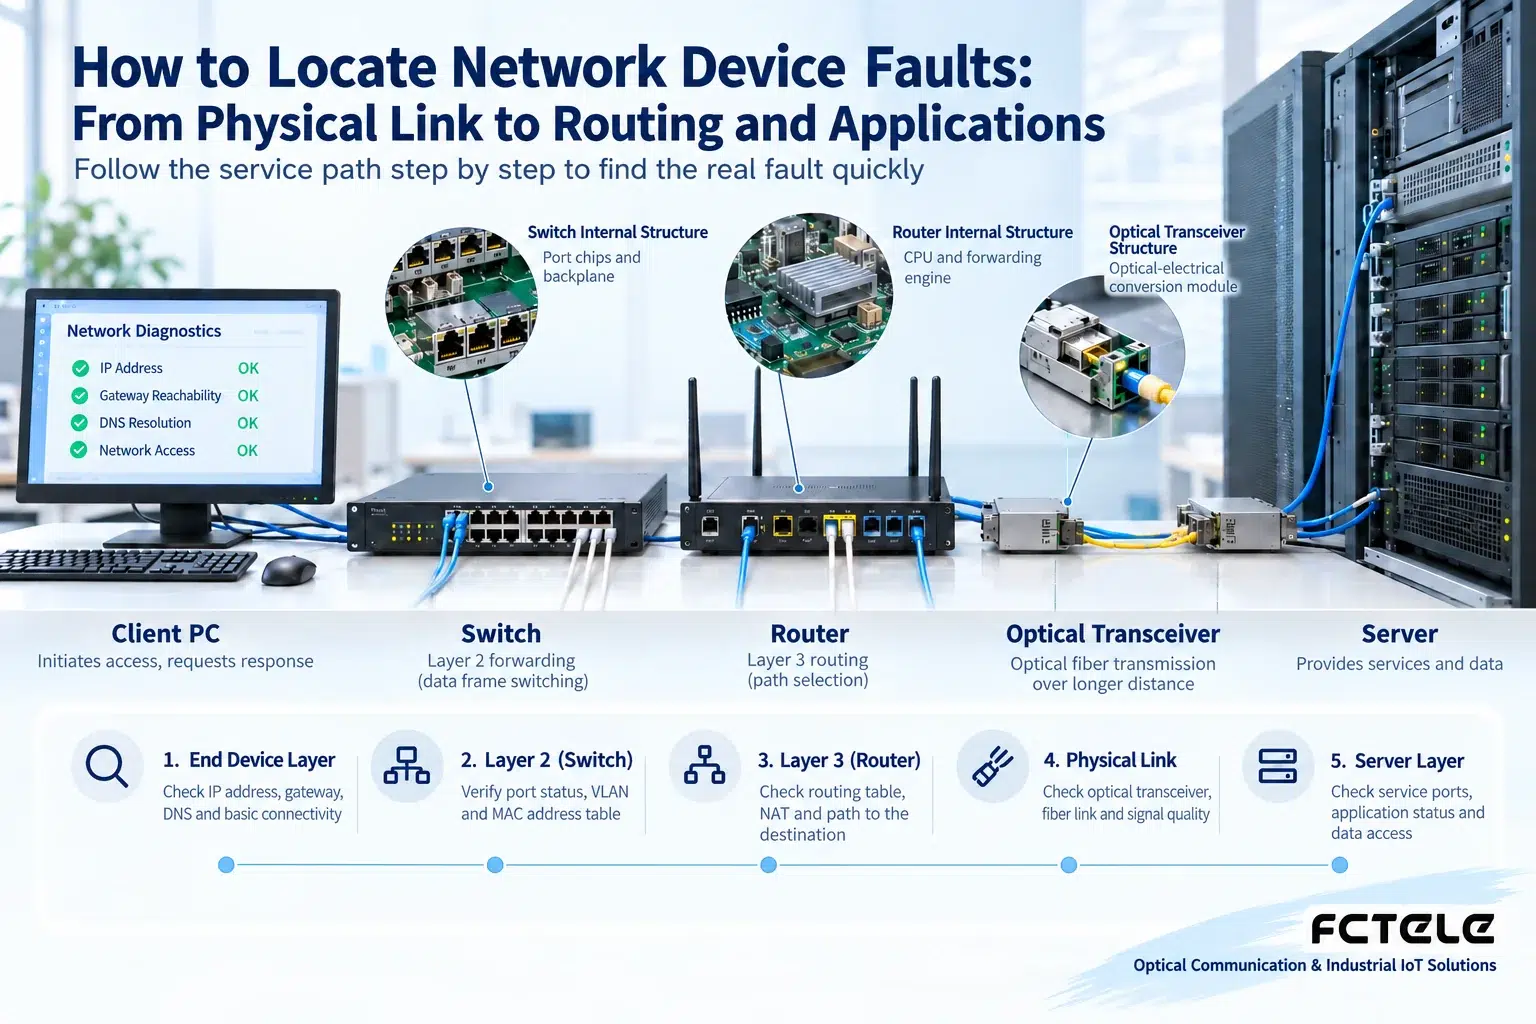 端末、スイッチ、ルーター、サーバー、光リンクはそれぞれ役割が異なるため、サービスの通信経路に沿って層ごとに障害を特定する必要があります。
物理層:電源とリンクは安定しているか
端末とネットワーク機器の電源、ポート、ネットワークケーブル、光モジュールを確認します。リンクランプの消灯は、ケーブル、無効化されたポート、速度の不一致、対向側の電源断が原因の場合もあり、必ずしもスイッチの故障を意味しません。リンクの再接続が頻発する場合は、エラーカウンターと電源状態を記録し、正常動作が確認されているケーブルやポートを使用して、計画的に切り替えてください。
光ファイバートランシーバーでは、シングルモードとマルチモードの適合性、波長、送受信の方向、許容光パワーも確認する必要があります。光ポートのランプが点灯していても、IPサービスがすでに動作しているとは限らず、光パワーに十分な余裕があるとも限りません。清掃前に端面を点検し、光ポートを直接のぞき込まないでください。どの変更が効果をもたらしたか判断しやすいよう、一度に変更する条件は1つだけにします。
レイヤー2:端末は正しいネットワークに接続されているか
ポートが想定したVLANに所属しているか、アップリンクでそのVLANが許可されているか、MACアドレスの学習が正常かを確認します。インターフェース統計のCRCエラーは物理伝送の問題を示す場合があり、ドロップは輻輳に関係する場合もあります。カウンターの増加をすべて同じ原因で説明してはいけません。
ループは、異常なブロードキャスト動作やMACテーブルのフラッピングを引き起こすことがあります。この現象が見つかった場合は、ケーブルの接続を続けるのではなく、事前に定めた計画に従って問題のあるリンクを切り離し、保護プロトコルとトポロジーを確認します。VLANの設定ミスは、ポートのランプが正常でも端末同士を検出できないという形で現れる場合があります。
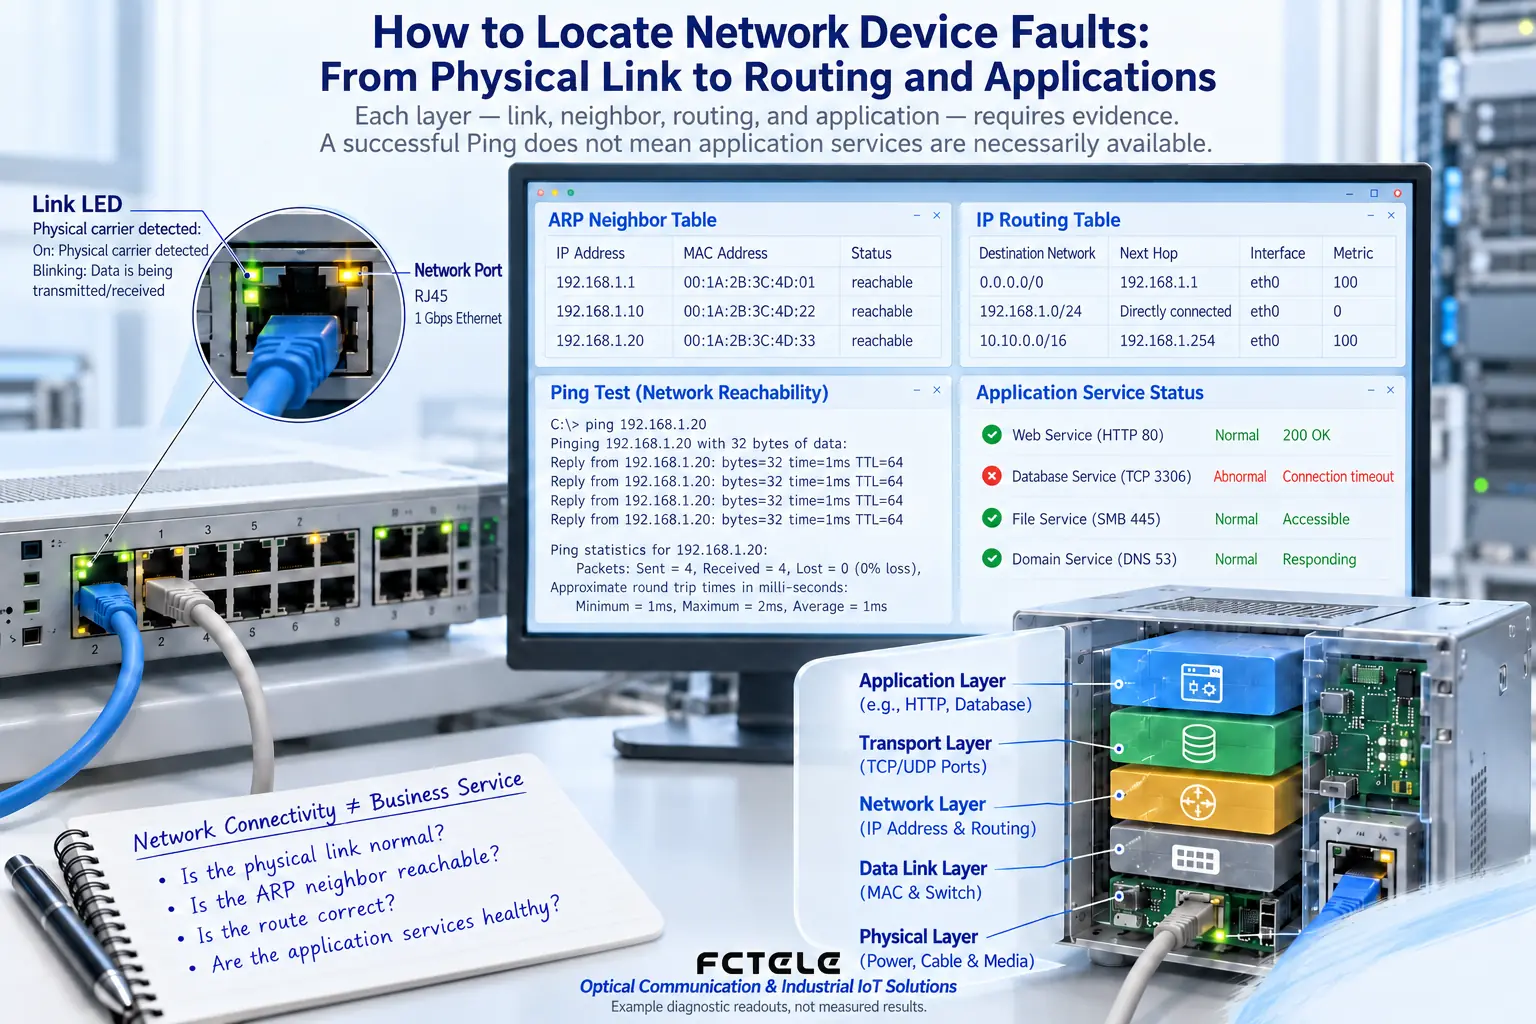 リンク、ネイバー、経路、アプリケーションのそれぞれに証拠が必要です。Pingの成功は、業務サービスが確実に利用できることを意味しません。
レイヤー3:アドレスと経路は整合しているか
端末のIP、マスク、ゲートウェイ、およびアドレスの競合を確認します。まずローカルネットワークを検証し、次にネットワークセグメント間の経路を確認します。ルーターの経路、アクセスポリシー、アドレス変換はいずれも、特定方向の通信に影響する可能性があります。一方向に到達できても、逆方向の経路も正しいとは限りません。
Pingの失敗は、ポリシーによってテスト通信が制限されていることが原因の場合もあるため、それだけで機器がオフラインだと判断することはできません。ネイバーテーブル、経路、機器ログ、許可された業務テストを組み合わせて判断します。DNSに異常があると、ドメイン名でのアクセスは失敗しても、アドレスを直接指定すれば成功する場合があります。ただし、アプリケーションがドメイン名や証明書に依存しているかどうかは、引き続き確認する必要があります。
アプリケーション:サーバーは実際にサービスを提供しているか
サーバーがネットワーク疎通確認に応答しても、アプリケーションが起動していない、誤ったアドレスで待ち受けている、リソースが不足している、または障害のあるデータベースに依存している場合があります。サービスの状態、ポート、ログ、リソース使用状況を確認します。ネットワークが担うのは経路上でデータを届けることだけであり、アプリケーション内部のエラーを自動的に修復することはありません。
復旧後は、接続性だけでなく、実際のユーザー操作を検証してください。原因、対処内容、再テストの結果を保守報告書に記録し、正常時の基準状態を保持します。経路、ファイアウォール、本番環境の設定を変更する必要がある場合は、先にバックアップを取り、ロールバックを準備してください。単に「動くようにする」ために、すべてのアクセスを無条件に許可してはいけません。
高負荷時にのみ障害が発生する場合は、アイドル時だけでテストするのではなく、トラフィックとリソース使用状況の推移を比較します。テスト用トラフィックも、制御せずに本番ネットワークへ流し込んではいけません。診断そのものが輻輳を引き起こさないよう、範囲とレートを設定してください。
中国語の技術記事からの翻訳です。原文の初回公開日:2020-05-20。原文の最終改訂日時:2026-10-13T23:18:15+08:00。 中国語の原文を読む
実務上のよくある質問
すべてのネットワーク機器を再起動すると、繰り返し発生する障害の特定が難しくなるのはなぜですか?
カウンターやログが消去されたり、複数の条件が同時に変化したりする可能性があるためです。まず影響範囲とタイムスタンプを記録して保持し、その後、承認済みの変更を管理された条件下で実施して、得られた証拠を比較してください。
一方向の到達性だけで、ルーティングを伴うアプリケーションの通信経路全体が正常に機能していると判断できますか?
いいえ。応答の経路や方向別のポリシーに問題が残っている可能性があります。往路の疎通確認1回を経路全体の検証とみなすのではなく、双方向と、許可された業務通信を確認してください。
サーバーがpingに応答していても、必要な業務アプリケーションが利用できないのはなぜですか?
サービスが動作していない、別のアドレスやポートで待ち受けている、依存先に障害がある、または認可に問題がある可能性があります。実際の操作をテストしてください。疎通確認では、これらのアプリケーションの状態を検証できません。
出典と適用範囲
これらの補足は一般的な仕組みを説明するものです。対応機能、接続の詳細、受入判定基準は、実際の機器、ソフトウェア、運用条件に合わせて検証する必要があります。図は測定結果や認証の証拠ではありません。



